Введение в ИИ и RLCD
Why TypeSafe trains decision models with calibrated probabilities instead of optimizing for generated text.
Почему TypeSafe обучает модели принятия решений с калиброванными вероятностями вместо оптимизации под генерацию текста.
Большинство продуктов в сфере ИИ построены вокруг диалога между моделью и человеком. TypeSafe исходит из другой гипотезы: в масштабной автоматизации будут преобладать взаимодействия ИИ-с-ИИ и ИИ-с-ПО, поэтому машинный интерфейс имеет большее значение, чем интерфейс чата.
Мы называем это машинным интеллектом (Machine Native Intelligence):
ИИ со свойствами программного обеспечения: структурированностью, надежностью, наблюдаемостью, тестируемостью, скоростью, консистентностью и низкой стоимостью.
Создаем продакшен, а не божество
TypeSafe не пытается создать модель, умеющую делать всё. Она разработана для продакшен-систем, где коду требуется четкое, точечное решение, которое можно проанализировать и на основе которого можно выполнить действие.
По нашим оценкам, крупномасштабная автоматизация на базе ИИ будет на 99% состоять из взаимодействий между машинами и лишь на 1% — из взаимодействия с человеком. Это смещает фокус проектирования с ответов, которые приятно читать, на выходы, которые предсказуемо ведут себя внутри программного обеспечения.
Прочтите манифест TypeSafe.
Три подхода к дообучению
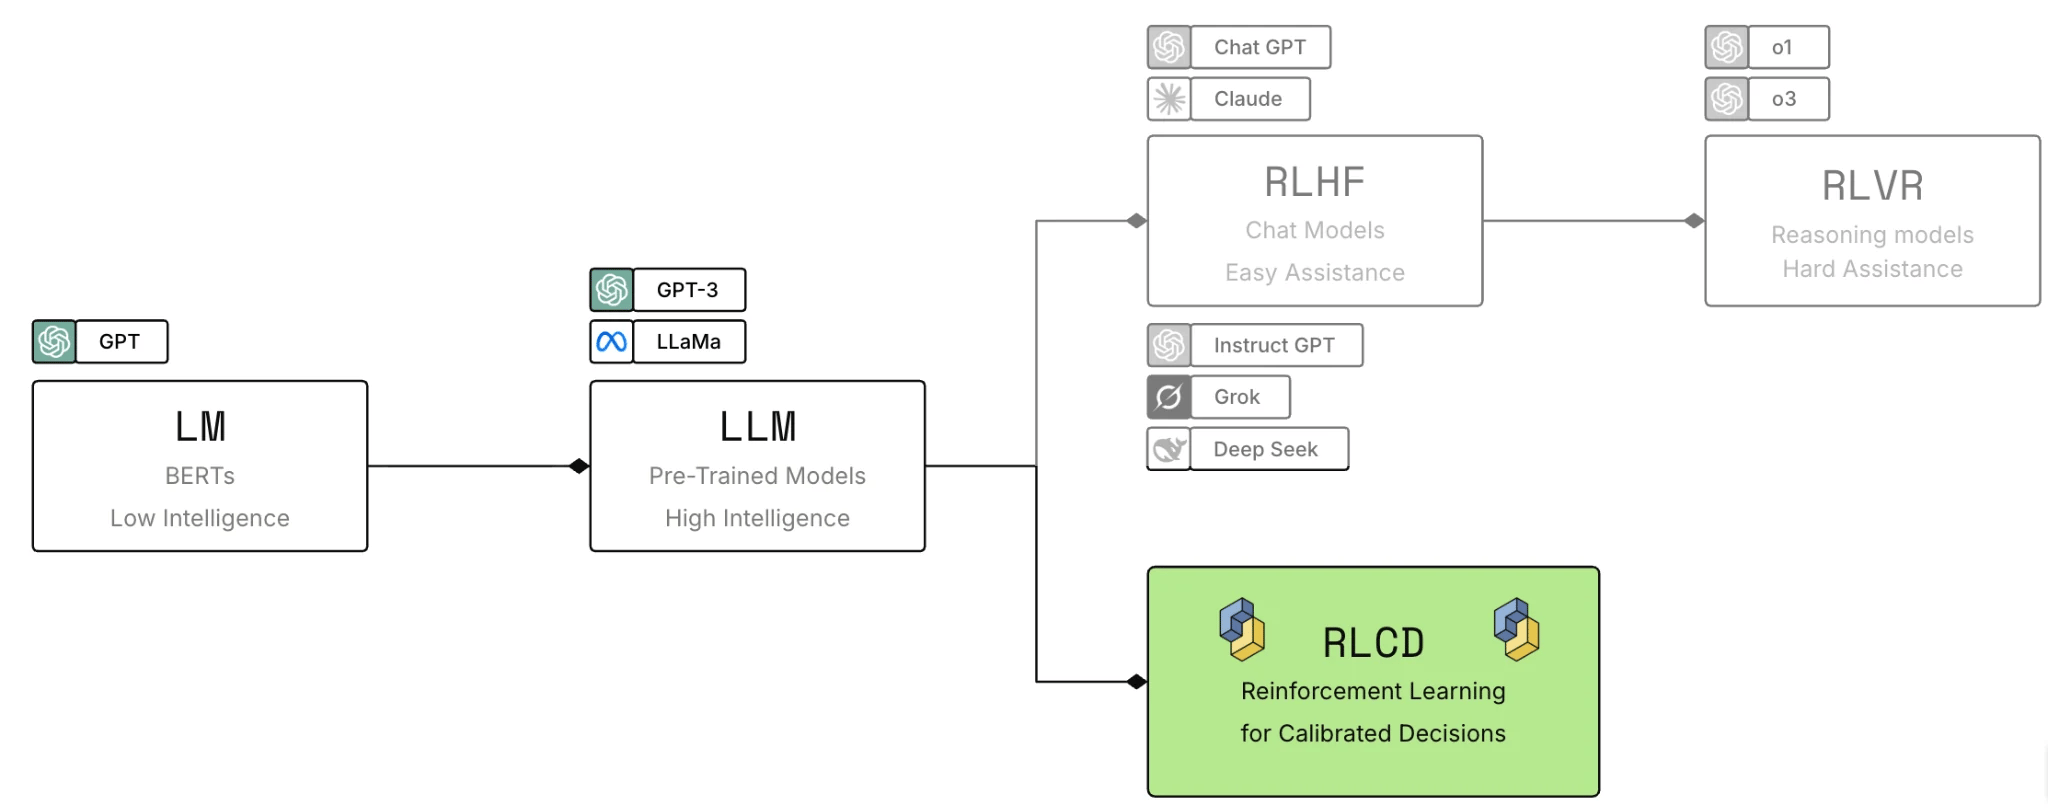
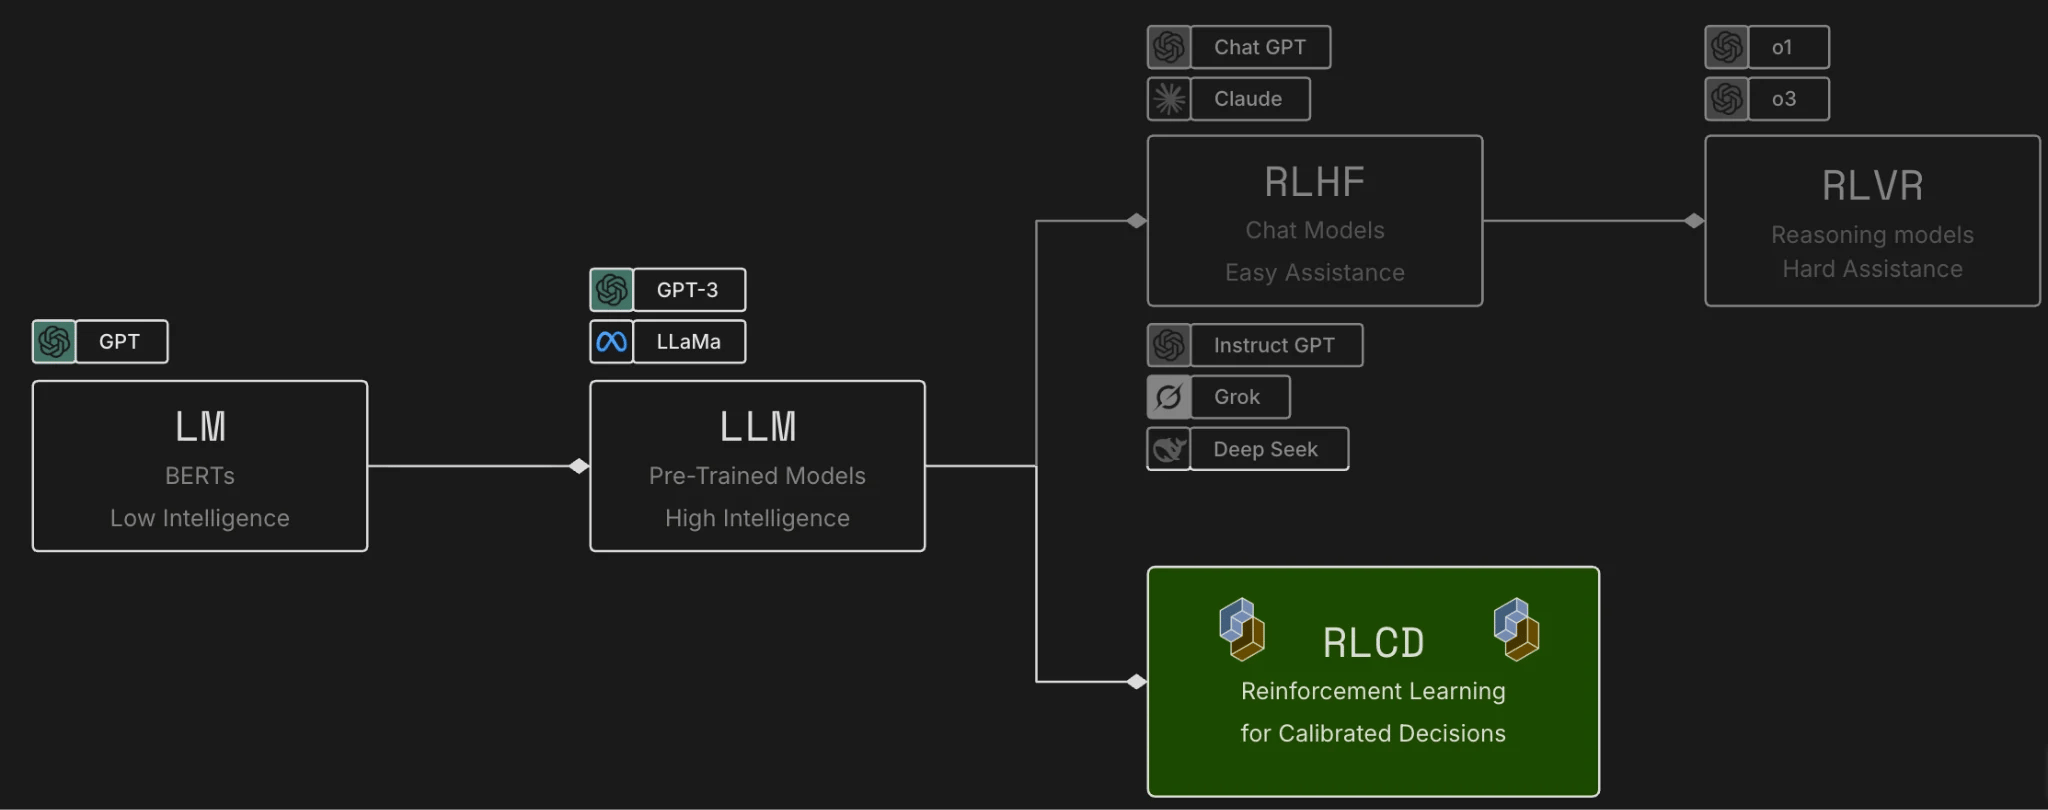
Предобученные языковые модели адаптировались двумя основными способами. TypeSafe добавляет третий. RLHF и RLVR приведены здесь для контекста; путь обучения TypeSafe — это RLCD.
RLHF использовался для обучения InstructGPT и ChatGPT и был разработан в соавторстве с Диого Алмейдой (Diogo Almeida), сооснователем TypeSafe.
RLCD и калиброванные решения
RLCD оптимизирует модель под совершенно другой контракт вывода:
- Модель не генерирует текст.
- Она возвращает решения и вероятности.
- Более высокая вероятность должна соответствовать более высокому шансу правильности ответа.
Калибровка делает неопределенность применимой в программном коде. На большой выборке предсказаний хорошо откалиброванной модели:
- События, которым присвоена вероятность
0.2, должны происходить примерно в 20% случаев. - События, которым присвоена вероятность
0.8, должны происходить примерно в 80% случаев. - События, которым присвоена вероятность
1.0, должны происходить в 100% случаев.
Эти показатели описывают группы предсказаний, а не служат гарантией для каждого отдельного ответа. Рекомендации о том, когда коду следует действовать автоматически, а когда передавать задачу на эскалацию человеку, см. в разделе Уверенность (Confidence).
Проблемы с RLHF
RLHF учит модель говорить то, что нравится людям. Эта цель хорошо подходит для чат-ботов, но она также может поощрять поддакивание (sycophancy) и уверенно звучащие галлюцинации.
Оптимизация предпочтений также приводит к выпадению мод (mode dropping): модель учится отдавать предпочтение определенному стилю (например, следованию инструкциям), одновременно снижая вероятность других возможных результатов.
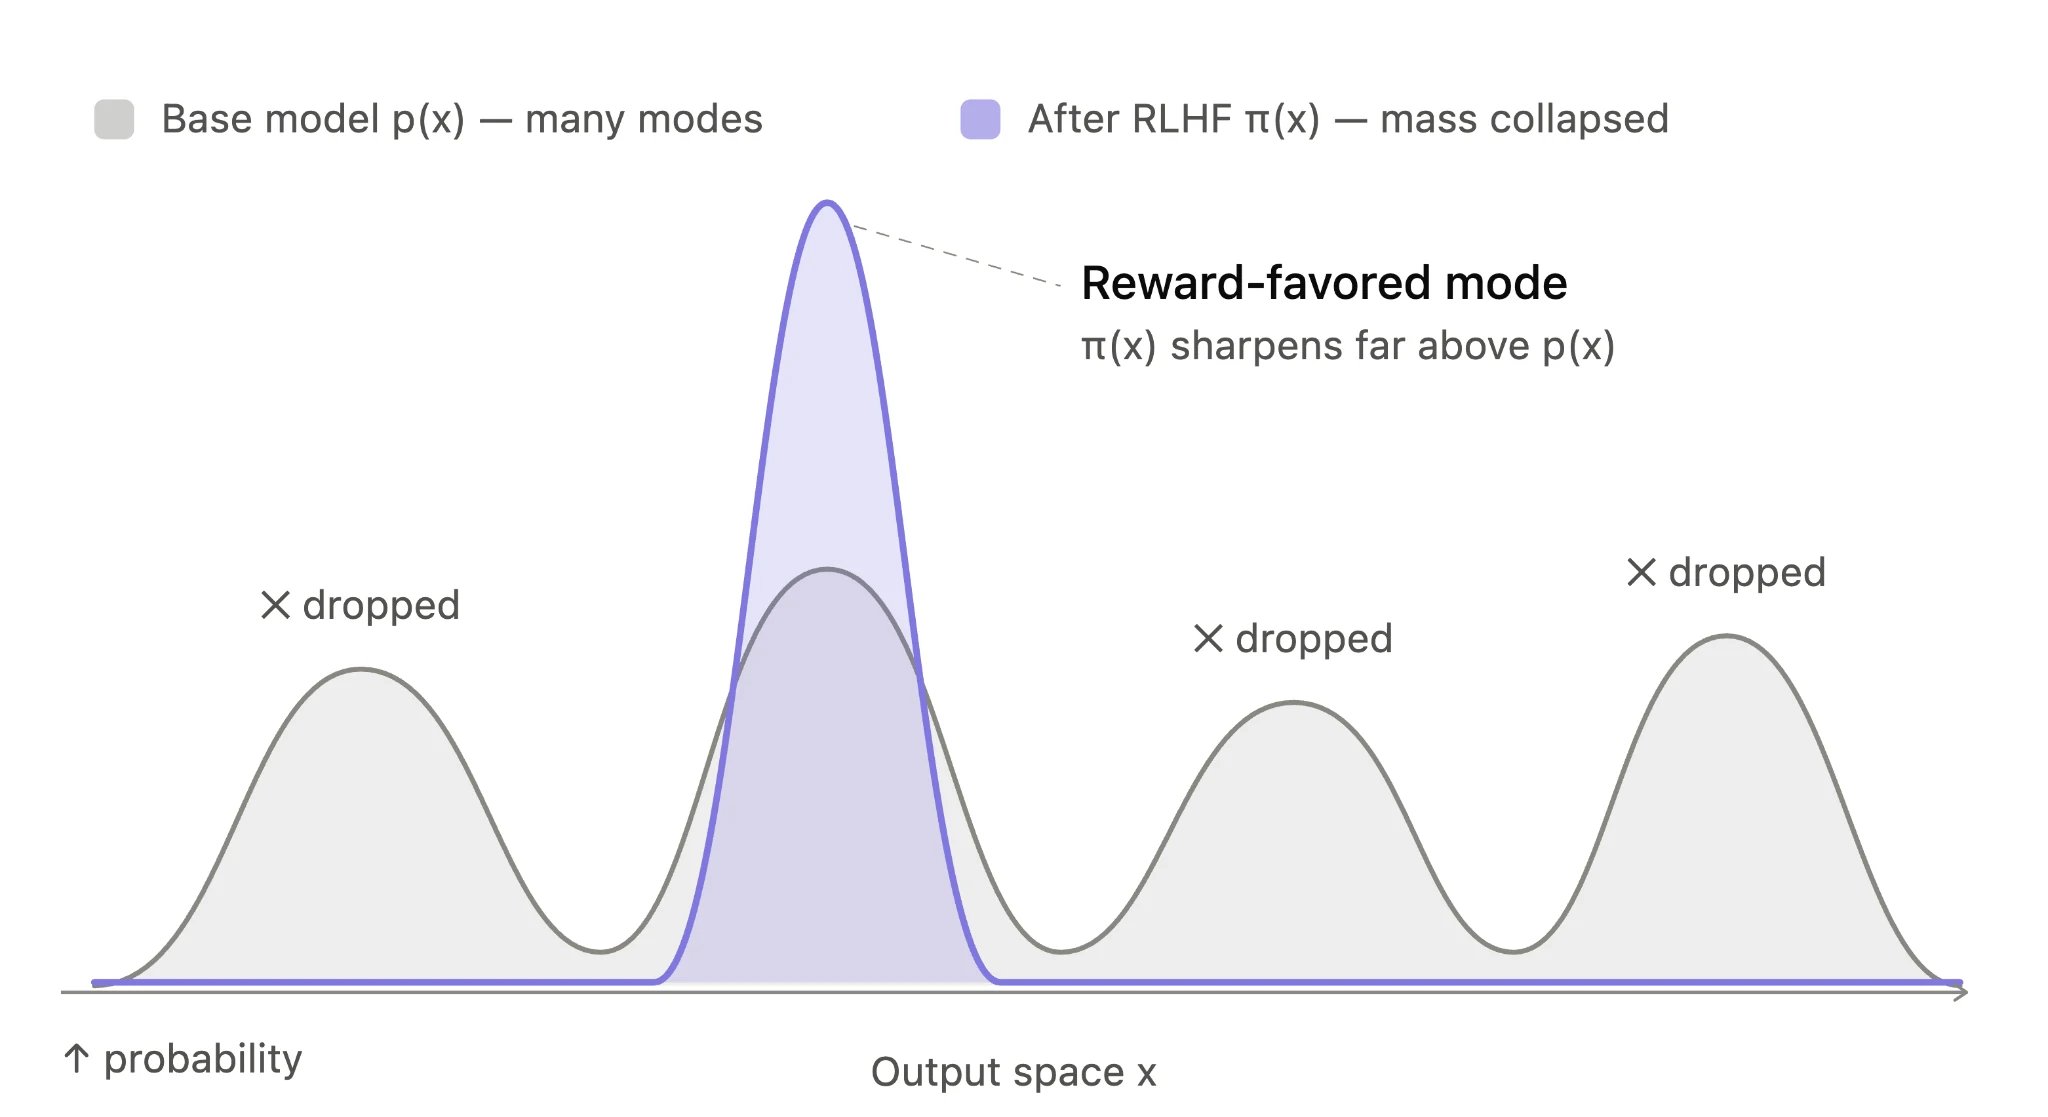
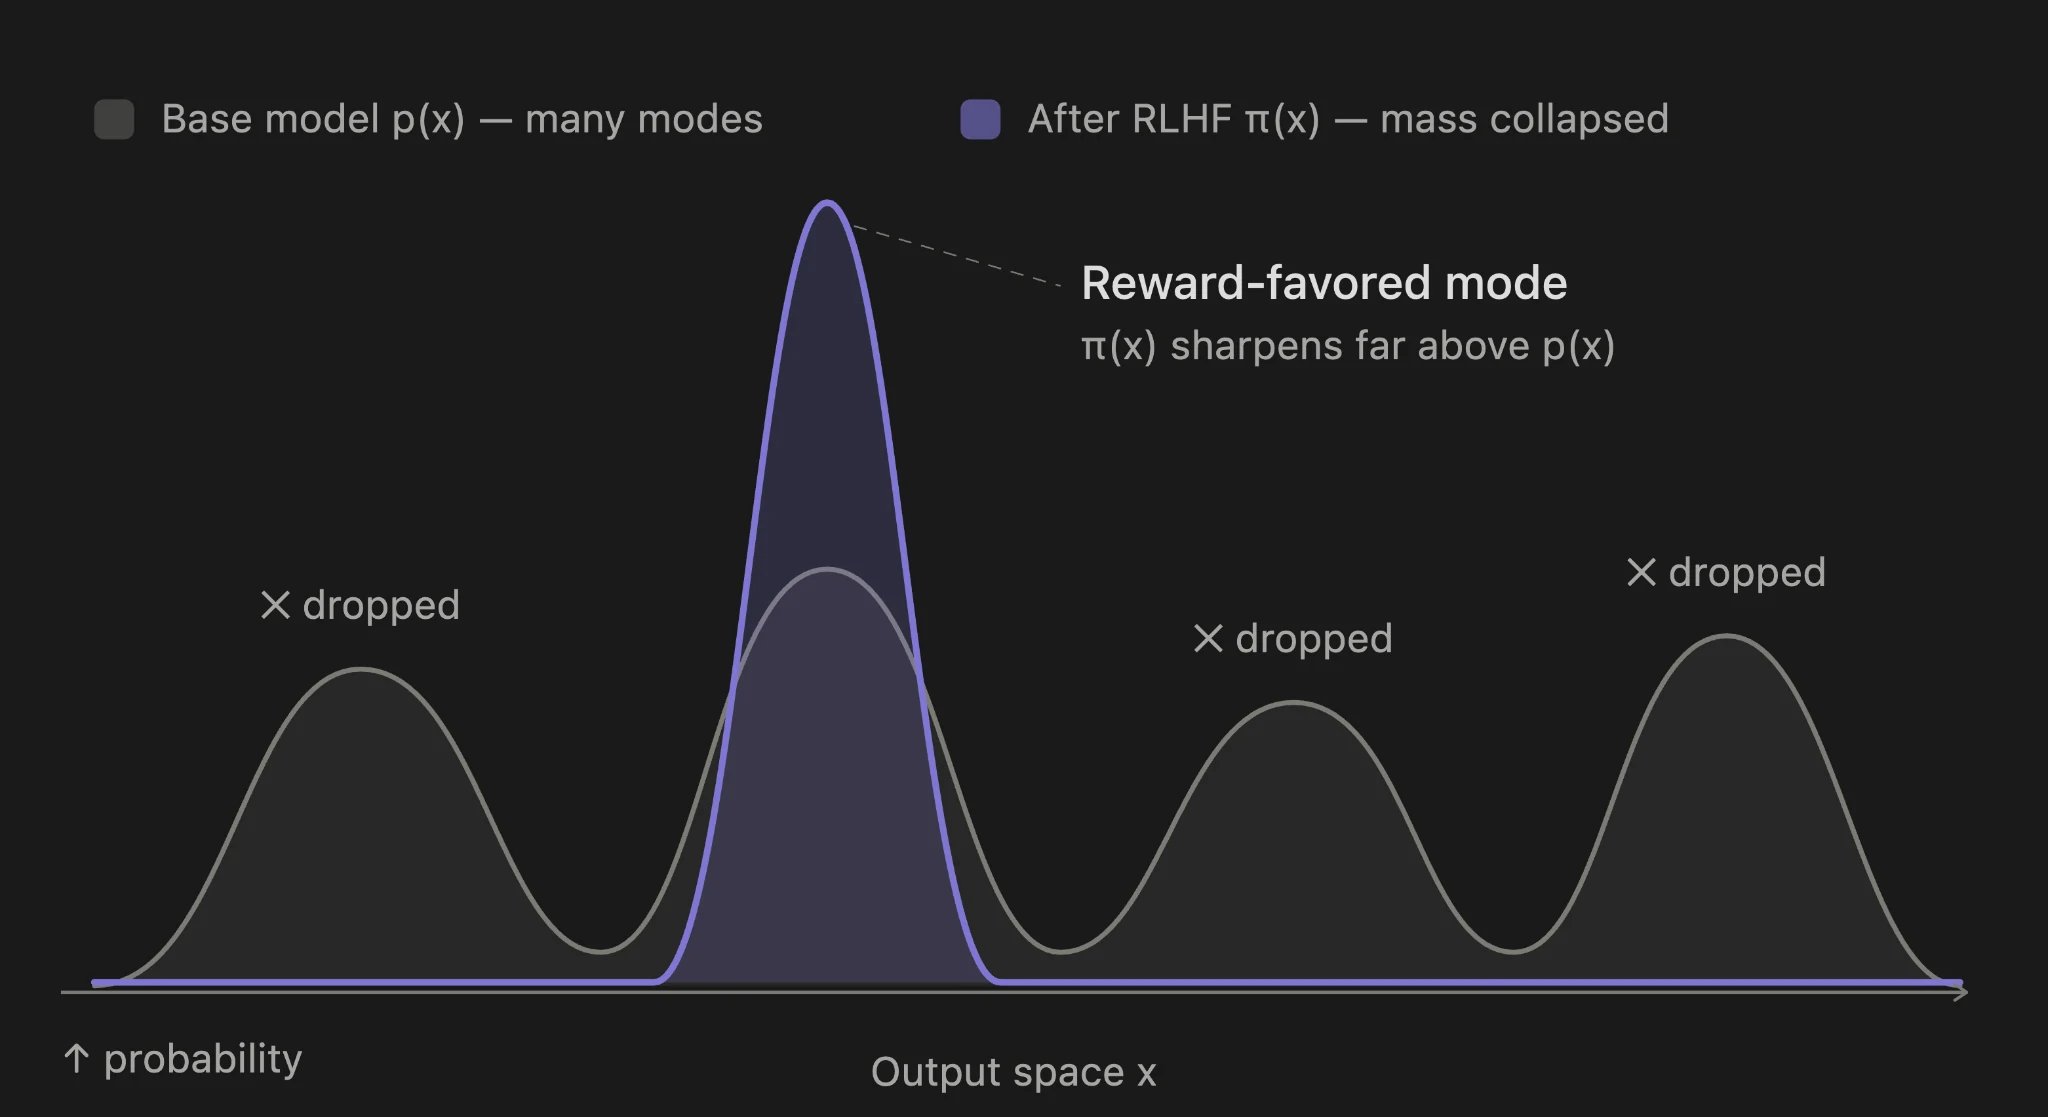
Выпадение мод — это более мягкая форма коллапса мод (mode collapse). В классическом сценарии сбоя генеративно-состязательной сети (GAN) генератор учится многократно воспроизводить один и тот же тип вывода, поскольку этот вывод продолжает успешно обманывать дискриминатор.
<img className="hidden dark:block" src="/docs-assets/7cdc26_mode-collapse-dark.webp" alt="Повторяющиеся символы иллюстрируют GAN в состоянии коллапса мод." width="1084" height="759" data-path="images/ai-primer/mode-collapse-dark.webp" />RLHF остается отличным решением для диалоговых моделей. Позиция TypeSafe заключается в том, что автоматизация в продакшене требует иной цели обучения — ориентированной на ограниченные решения и калиброванную неопределенность.