Переранжирование поиска (Re-ranking)
Builds 30-passage BM25 shortlists for 40 CLERC legal queries, then uses one TypeSafe question per query-candidate pair to raise top-1 accuracy from 5% to 18% and top-10 accuracy from 38% to 62%.
Формирует шортлисты из 30 отрывков с помощью BM25 для 40 юридических запросов CLERC, а затем использует один вопрос TypeSafe на каждую пару «запрос–кандидат», повышая точность top-1 с 5% до 18%, а точность top-10 — с 38% до 62%.
У вас есть тысячи документов, и вам нужно найти тот единственный, который отвечает на конкретный вопрос. Как его найти?
Сначала используйте быстрый метод, например поиск по ключевым словам, чтобы сократить тысячи кандидатов до небольшого списка наиболее вероятных. Мы называем это быстрым поиском (fast search).
Быстрый поиск отлично справляется с этой задачей, но он не может определить, какой именно кандидат из шортлиста является правильным. Здесь на помощь приходит переранжирование (re-ranking). Оно оценивает каждого кандидата из шортлиста напрямую относительно запроса и ставит наилучший вариант на первое место.
Оба этапа выполняются ниже на 3 565 фрагментах судебных решений из датасета CLERC: BM25 формирует шортлист быстрого поиска из 30 кандидатов для каждого из 40 запросов, после чего TypeSafe переранжирует каждый шортлист. Благодаря переранжированию правильный фрагмент оказывается на первом месте в 18% запросов по сравнению с 5% при использовании только быстрого поиска.
В процессе вы узнаете:
- Что делает быстрый поиск и почему одного его недостаточно
- Что такое переранжирование и как оно встраивается после этапа быстрого поиска
- Как TypeSafe оценивает кандидата относительно запроса и насколько это улучшает результат
Попробуйте сами
Открыть запрос, кандидата и вопрос переранжирования в песочнице TypeSafe
Как найти один документ среди тысяч?
У вас есть массив документов и запрос — фрагмент текста, описывающий то, что вы ищете. Где-то в этом массиве находится единственный документ, отвечающий на него.
Поочередная проверка каждого документа относительно запроса технически работает: по одному сравнению на документ, однако миллионы документов означают миллионы сравнений на каждый запрос. Производительность можно кардинально повысить с помощью двухэтапного подхода:
- Сократить массив до короткого списка вероятных кандидатов с помощью метода, достаточно быстрого для обработки всего массива.
- Применить более точный этап к этому шортлисту, чтобы найти точный правильный ответ.
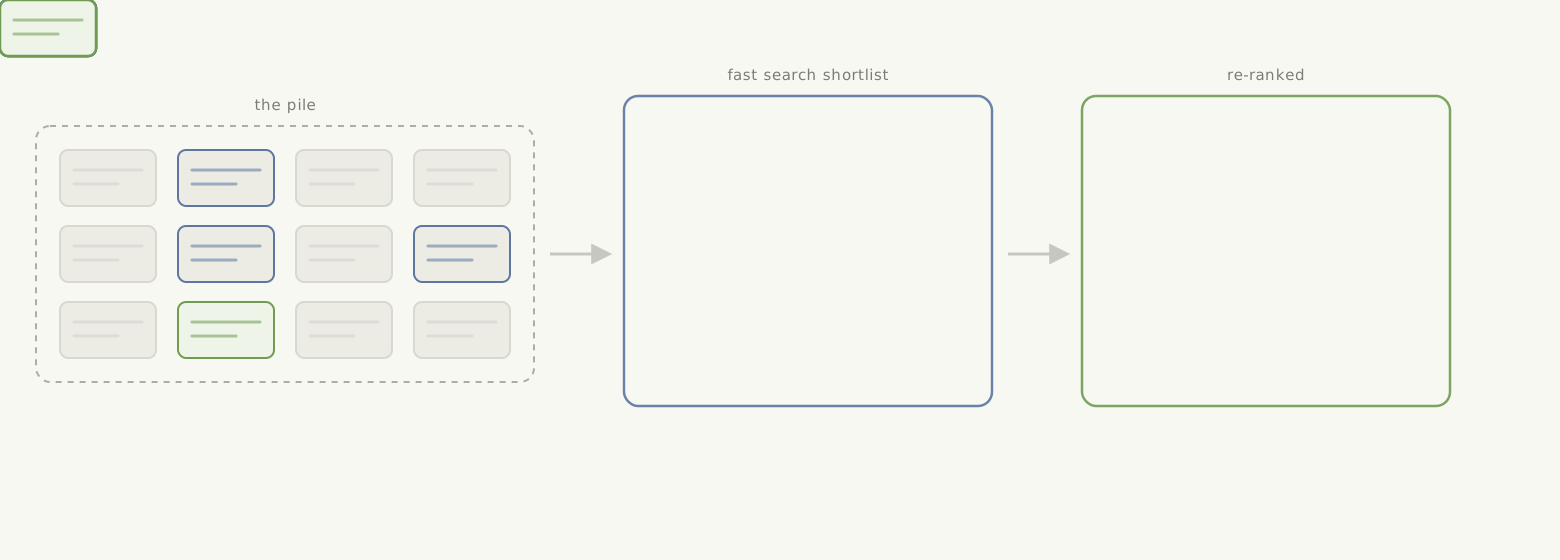
В этом руководстве данная схема тестируется на датасете судебных решений в разделе Пример переранжирования ниже.
Что такое быстрый поиск?
Быстрый поиск — это любой метод, способный сравнить запрос со всеми документами в большом корпусе и быстро вернуть ранжированный шортлист. К распространенным методам относятся поиск по ключевым словам (например, BM25) и плотные векторные эмбеддинги (dense embeddings), сравнивающие фрагменты по смыслу. Системы часто комбинируют оба подхода.
На первом этапе здесь используется только BM25. BM25 ранжирует фрагменты по пересечению слов. Простота этого шага позволяет сосредоточиться на переранжировании, ради которого и создано это руководство. Выбор метода быстрого поиска вторичен: переранжирование работает только с теми фрагментами, которые попали в шортлист.
Что такое переранжирование?
Переранжирование берет шортлист, уже сформированный быстрым поиском, и упорядочивает его более качественно. Вместо сравнения запроса со всем корпусом сразу оно сравнивает запрос с каждым кандидатом из шортлиста по отдельности и сортирует шортлист по этой оценке.
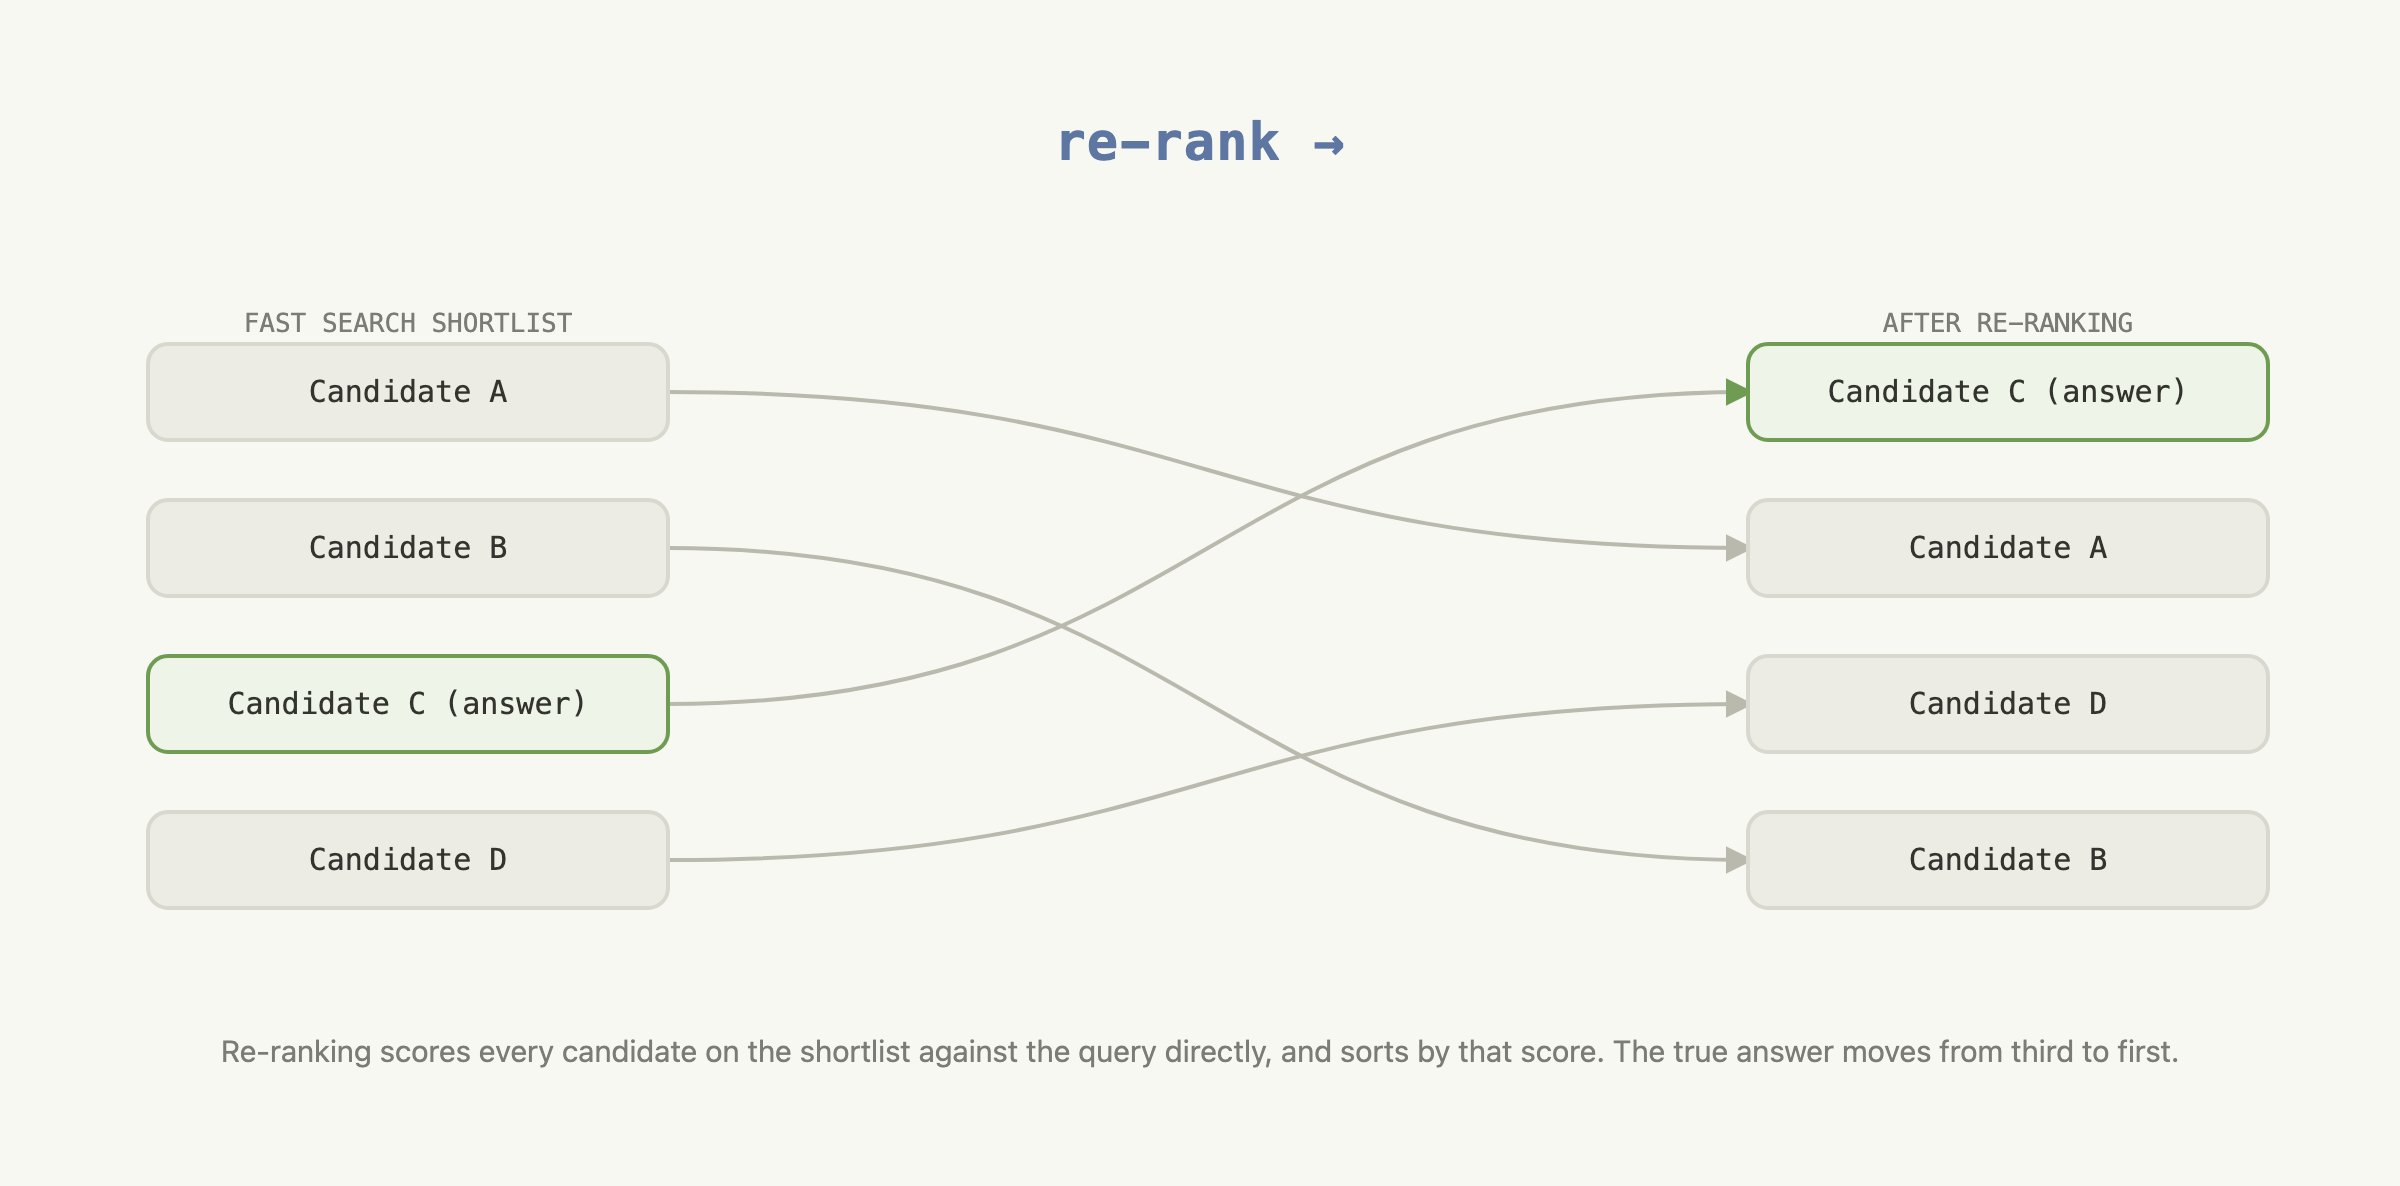
Оценка может формироваться языковой моделью. Передайте ей запрос и одного кандидата вместе и спросите, насколько хорошо кандидат отвечает на запрос. Переранжирование позволяет найти наилучшее совпадение в шортлисте, даже если его формулировки отличаются от слов в запросе.
Переранжирование с помощью TypeSafe
Системе переранжирования требуется сопоставимая оценка для каждой пары «запрос–кандидат». Универсальная языковая модель может выдавать такие оценки или ранжировать весь шортлист целиком. Однако для независимой оценки пар необходимо определять шкалу баллов и составлять промпт так, чтобы модель применяла единый стандарт к каждому кандидату. Повторные вызовы все равно могут давать разные баллы для одной и той же пары, а генерация текста универсальной моделью увеличивает время и стоимость задачи, для которой требуется всего одно число.
Что возвращает TypeSafe
С TypeSafe запрос на оценку может оставаться простым вопросом «да/нет»:
Could this candidate passage be from the cited precedent?Простого ответа «да» или «нет» было бы недостаточно для ранжирования 30 кандидатов. Вместо этого Noul возвращает число от 0 до 1, называемое noul. Noul — это оценка TypeSafe того, насколько вероятен ответ «да».
Критерии вопроса определяют, что считать истиной, а что — ложью. TypeSafe применяет их к каждой паре «запрос–кандидат» и возвращает значение noul напрямую. Это значение и служит баллом, по которому приложение выполняет сортировку. Нет необходимости придумывать шкалу баллов для универсальной модели, а TypeSafe спроектирован так, чтобы выполнять такое повторяющееся скорирование быстрее, дешевле и стабильнее.
В упрощенном псевдокоде один вызов оценки TypeSafe выглядит так:
question = Noul(
    instructions="Is this candidate the cited case?",
    criteria=NoulCriteria(
        true="The candidate states the specific rule the query cites.",
        false="The candidate is only on a similar topic.",
    ),
)
response = client.system_one(state={...}, questions={"is_cited_source": question})
response.answers["is_cited_source"].noul  # -> 0.87
TypeSafe оценивает запрос и одного кандидата вместе относительно этого вопроса и возвращает noul.
Вы можете использовать это для переранжирования шортлиста, задавая один и тот же вопрос по каждому кандидату из него, а затем сортируя шортлист по убыванию полученного значения noul.
nouls = {candidate: ask_typesafe(query, candidate) for candidate in shortlist}
reranked = sorted(shortlist, key=lambda c: nouls[c], reverse=True)  # highest noul first
На диаграмме ниже показано, как один запрос на каждого кандидата формирует оценки, используемые для упорядочивания шортлиста.
flowchart LR
    q["фрагмент запроса<br/><i>один отрывок судебного решения,<br/>цитата удалена</i>"]
    sl["шортлист быстрого поиска<br/><i>30 кандидатов</i>"]
    quest["<b>один Noul</b><br/>может ли этот кандидат быть<br/>из цитируемого прецедента?<br/><i>критерии задают true и false</i>"]

    %% direction LR inside an LR chart keeps each state beside its noul, two columns,
    %% so the fan-out is four rows tall instead of eight
    subgraph fan["один запрос на кандидата · запросы изолированы"]
        direction LR
        d1["state<br/>{query, кандидат 1}"] --> n1["noul<br/>0.87"]
        d2["state<br/>{query, кандидат 2}"] --> n2["noul<br/>0.41"]
        dx["⋮"] --> nx["⋮"]
        d30["state<br/>{query, кандидат 30}"] --> n30["noul<br/>0.12"]
    end

    sort["сортировка по noul,<br/>по убыванию"]
    out["переранжированный шортлист<br/><i>те же 30, лучший порядок</i>"]

    q --> fan
    sl --> fan
    quest --> fan
    fan --> sort --> out

    %% the elision is not a node - drop its box so it reads as "and so on"
    classDef elide fill:none,stroke:none
    class dx,nx elide
    linkStyle 2 stroke:none
Пример переранжирования
Быстрый поиск и переранжирование выполняются на датасете CLERC, предназначенном для оценки информационного поиска в юридической сфере. В этом примере используются 3 565 фрагментов судебных решений и 40 запросов.
Настройка
На первом шаге устанавливаются пакеты, необходимые для работы руководства:
bm25sиdatasetsформируют шортлист быстрого поиска.typesafe-sdkиcooksafeотвечают за переранжирование и кэширование API.matplotlibстроит графики с результатами.
pip install bm25s datasets matplotlib "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/Следующий блок инициализирует клиент TypeSafe и константы, используемые в руководстве: модель TypeSafe и размер шортлиста, который быстрый поиск передает модулю переранжирования. Для вызова TypeSafe требуется TYPESAFE_API_KEY.
import hashlib
import json
import os
import random
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

import msgspec
from cooksafe import JsonCache
from IPython.display import display
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

TYPESAFE_MODEL = "jev-1.12"
PRICE = (
    0.042,
    0.00,
)  # $ per 1M tokens (input, output); TypeSafe jev-1.12 as of 2026-08
N_ROWS = 170  # CLERC rows pooled into the shared corpus
N_QUERIES = 40  # rows we evaluate
TOP_K = 30  # candidates the shortlist hands to the re-ranker, per query

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),  # keyless kernels replay the cache
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Ранжирование фрагментов с помощью быстрого поиска
Используемый здесь датасет представляет собой корпус судебных решений США, объединенный из 170 строк. Каждая строка устроена следующим образом:
- Query (запрос): фрагмент судебного решения с удаленной цитатой.
- Gold (эталон): фрагмент, на который указывала удаленная цитата, — единственный правильный ответ на запрос.
- Candidates (кандидаты): все остальные фрагменты в корпусе, с которыми запрос мог бы быть ошибочно сопоставлен.
Из 170 строк 40 отобраны для оценки в качестве запросов. Остальные 130 выступают исключительно в роли кандидатов.
Следующая ячейка строит шортлист по описанной выше методике:
- Загрузить корпус.
- Проранжировать его для каждого запроса с помощью BM25.
Здесь пока нет TypeSafe — это исключительно этап быстрого поиска.
CLERC_FILE = (
    "https://huggingface.co/datasets/jhu-clsp/CLERC/resolve/main/"
    "teva_train_dir/train_data.jsonl.gz"
)


def cid(text: str) -> str:
    """Corpus id: a content hash, so passages shared across queries dedupe."""
    return hashlib.sha1(text.encode("utf-8")).hexdigest()[:16]


@json_cache
def build_slice(n_rows: int, n_queries: int, seed: int) -> dict:
    """Stream CLERC rows, pool ``n_rows`` of them into a corpus, pick ``n_queries`` to evaluate."""
    from datasets import load_dataset  # heavy import, keep local

    stream = load_dataset("json", data_files=CLERC_FILE, streaming=True, split="train")
    rows = []
    for row in stream:
        if (
            row.get("positive_passages")
            and len(row.get("negative_passages") or []) == 20
        ):
            rows.append(row)
        if len(rows) >= 1000:
            break

    rng = random.Random(seed)
    picked = rng.sample(rows, n_rows)
    corpus, pool = {}, []
    for row in picked:
        gold = row["positive_passages"][0]["text"]
        corpus[cid(gold)] = gold
        for neg in row["negative_passages"]:
            corpus[cid(neg["text"])] = neg["text"]
        pool.append(
            {"qid": str(row["query_id"]), "query": row["query"], "gold": cid(gold)}
        )
    # hold out the first 20 pooled rows; evaluate on the rest
    queries = rng.sample(pool[20:], n_queries)
    # sort the corpus by id so every run — live or cache replay — iterates it identically
    return {"queries": queries, "corpus": dict(sorted(corpus.items()))}


def bm25_rankings(corpus: dict[str, str], queries: dict[str, str], k: int = 100):
    """Rank every passage in the corpus by word overlap with each query."""
    import bm25s

    cids = list(corpus)
    retriever = bm25s.BM25()
    retriever.index(bm25s.tokenize([corpus[c] for c in cids], stopwords="en"))
    qids = list(queries)
    idxs, _ = retriever.retrieve(
        bm25s.tokenize([queries[q] for q in qids], stopwords="en"), k=min(k, len(cids))
    )
    return {q: [cids[i] for i in idxs[row]] for row, q in enumerate(qids)}


def gold_rank(ranked: list[str], gold: str) -> int | None:
    """1-based rank of the gold id, or None if it isn't in the list."""
    return ranked.index(gold) + 1 if gold in ranked else None


SURFACE, INK, INK2, MUTED = "#f8f8f2", "#34342f", "#34342f", "#7c7c77"
GRID, AXIS, BLUE, GREEN = "#d8d8cf", "#d8d8cf", "#5d76a2", "#6f9b52"


def bar_chart(labels: list[str], shares: list[float], title: str) -> None:
    """A small single-series bar chart of shares (0-1, shown as percentages)."""
    import matplotlib.pyplot as plt

    fig, ax = plt.subplots(figsize=(5, 3.2), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    bars = ax.bar(labels, shares, width=0.55, color=[BLUE, GREEN][: len(labels)])
    ax.bar_label(
        bars,
        labels=[f"{s * 100:.0f}%" for s in shares],
        padding=4,
        color=INK,
        fontsize=11,
    )
    ax.set_ylim(0, 1.1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(title, loc="left", color=INK, fontsize=11)
    plt.tight_layout()
    display(fig)
    plt.close(fig)


ds = build_slice(N_ROWS, N_QUERIES, seed=0)
corpus: dict[str, str] = ds["corpus"]
queries = {q["qid"]: q["query"] for q in ds["queries"]}
golds = {q["qid"]: q["gold"] for q in ds["queries"]}

candidates = {q: ranked[:TOP_K] for q, ranked in bm25_rankings(corpus, queries).items()}

in_top_k = sum(golds[q] in candidates[q] for q in queries)
at_rank_1 = sum(candidates[q][0] == golds[q] for q in queries)

bar_chart(
    [f"In top {TOP_K}", "At rank 1"],
    [in_top_k / len(queries), at_rank_1 / len(queries)],
    f"Where the correct passage lands, {len(queries)} queries against {len(corpus):,} candidates",
)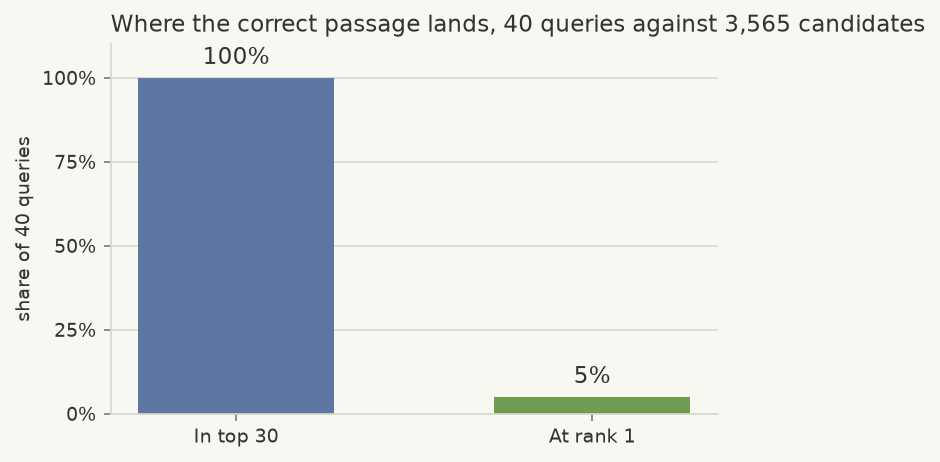
Быстрый поиск редко ставит правильный фрагмент на первое место
На графике показано, куда быстрый поиск помещает правильный фрагмент среди 3 565 кандидатов.
Быстрый поиск надежно сужает корпус до шортлиста, содержащего правильный ответ: он присутствует в шортлисте для 100% из 40 запросов. Однако этот фрагмент крайне редко оказывается на первом месте — всего в 5% случаев.
Переранжирование ниже лишь меняет порядок 30 кандидатов, уже отобранных в шортлист. Оно не может добавить фрагмент, который быстрый поиск не выбрал. В данном случае шортлист содержит правильный фрагмент для всех 40 запросов, поэтому переранжирование может сосредоточиться на выводе каждого из них на более высокую позицию.
Переранжирование с помощью TypeSafe
Переранжирование оценивает каждого кандидата из шортлиста относительно его запроса, а затем сортирует по полученному баллу. Вопрос, который TypeSafe задает по каждой паре: мог ли кандидат быть тем фрагментом, на который указывала удаленная из запроса цитата?
Следующая ячейка выполняет следующие действия:
- Определяет этот вопрос.
- Задает его один раз для каждого кандидата в каждом шортлисте (40 запросов умножить на 30 кандидатов — всего 1 200 вызовов, выполняемых параллельно, а не последовательно).
- Сортирует каждый шортлист по баллу, возвращенному TypeSafe, формируя переранжированный результат.
is_cited_source = Noul(
    instructions=(
        "The query excerpt comes from a US federal court opinion and was written "
        "immediately around a citation to a precedent; the citation itself has been "
        "removed. Could the candidate passage be from that cited precedent — does it "
        "establish the specific legal proposition the query excerpt invokes at its "
        "citation point?"
    ),
    criteria=NoulCriteria(
        true=(
            "The candidate passage states or establishes the specific rule, standard, "
            "holding, or fact pattern that the query excerpt attributes to its removed "
            "citation."
        ),
        false=(
            "The candidate passage is merely on a similar topic or doctrine; it does not "
            "supply the specific proposition the query excerpt relies on."
        ),
    ),
)


@json_cache
def score_candidate(model: str, query: str, candidate: str, question_json: str) -> dict:
    """One TypeSafe call about one (query, candidate) pair: a noul, plus token usage."""
    # the SDK takes a question as its JSON dict, so the cached string decodes straight in
    question = json.loads(question_json)
    response = client.system_one(
        state={"query_excerpt": query, "candidate_passage": candidate},
        questions={"is_cited_source": question},
        model=model,
    )
    return {
        "noul": response.answers["is_cited_source"].noul,
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


# Each of the 40 queries has 30 candidates, so re-ranking every shortlist means 1,200 independent
# calls — cheap enough to fire all at once with a thread pool instead of one after another.
pair_list = [(q, c) for q in queries for c in candidates[q]]
question_json = msgspec.json.encode(is_cited_source).decode()
with ThreadPoolExecutor(max_workers=12) as pool:
    results = pool.map(
        lambda p: score_candidate(
            TYPESAFE_MODEL, queries[p[0]], corpus[p[1]], question_json
        ),
        pair_list,
    )
pair_scores = {q: {} for q in queries}
for (q, c), result in zip(pair_list, results):
    pair_scores[q][c] = result

reranked = {
    q: sorted(candidates[q], key=lambda c: -pair_scores[q][c]["noul"]) for q in queries
}


def chart_before_after(
    runs: dict[str, dict[str, list[str]]], thresholds: list[int]
) -> None:
    """Grouped bar chart: how often the correct passage lands in the top N, for each run."""
    import numpy as np
    import matplotlib.pyplot as plt

    labels = list(runs)
    colors = [BLUE, GREEN]

    def share_in_top(rankings, k):
        return sum(
            gold_rank(rankings[q], golds[q]) in range(1, k + 1) for q in queries
        ) / len(queries)

    fig, ax = plt.subplots(figsize=(6.5, 3.6), facecolor=SURFACE)
    ax.set_facecolor(SURFACE)
    for side in ("top", "right"):
        ax.spines[side].set_visible(False)
    for side in ("left", "bottom"):
        ax.spines[side].set_color(AXIS)
    ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
    ax.set_axisbelow(True)
    ax.grid(axis="y", color=GRID, linewidth=0.8)

    x = np.arange(len(thresholds))
    width = 0.35
    for i, (label, rankings) in enumerate(runs.items()):
        shares = [share_in_top(rankings, k) for k in thresholds]
        offset = (i - (len(labels) - 1) / 2) * width
        bars = ax.bar(x + offset, shares, width * 0.92, color=colors[i], label=label)
        ax.bar_label(
            bars,
            labels=[f"{s * 100:.0f}%" for s in shares],
            padding=3,
            color=INK2,
            fontsize=8.5,
        )

    ax.set_xticks(x, [f"top {k}" for k in thresholds])
    ax.set_ylim(0, 1)
    ax.set_yticks([0, 0.25, 0.5, 0.75, 1.0])
    ax.set_yticklabels(["0%", "25%", "50%", "75%", "100%"])
    ax.set_ylabel(f"share of {len(queries)} queries", color=INK2, fontsize=9)
    ax.set_title(
        "How often the correct passage lands near the top",
        loc="left",
        color=INK,
        fontsize=11,
    )
    ax.legend(frameon=False, labelcolor=INK2, fontsize=9, loc="upper left")
    plt.tight_layout()
    display(fig)
    plt.close(fig)


chart_before_after(
    {"Fast search": candidates, "+ TypeSafe re-rank": reranked}, [1, 5, 10]
)

calls = [pair_scores[q][c] for q in queries for c in pair_scores[q]]
input_tokens = sum(call["input_tokens"] for call in calls)
output_tokens = sum(call["output_tokens"] for call in calls)
cost = input_tokens / 1_000_000 * PRICE[0] + output_tokens / 1_000_000 * PRICE[1]
print(
    f"{len(calls)} TypeSafe calls used {input_tokens:,} input and "
    f"{output_tokens:,} output tokens, costing ${cost:.4f}."
)1200 TypeSafe calls used 1,536,002 input and 25,200 output tokens, costing $0.0645.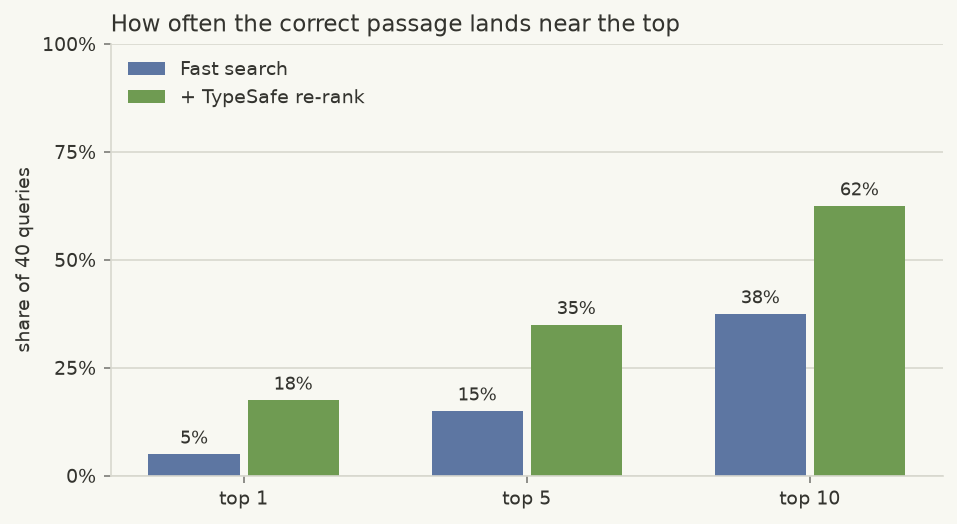
Переранжирование поднимает правильный ответ к началу списка
График сравнивает быстрый поиск и связку «быстрый поиск + переранжирование» на трех пороговых уровнях. Переранжирование приближает правильный фрагмент к началу списка на каждом из них:
- Top 1 — с 5% до 18%
- Top 5 — с 15% до 35%
- Top 10 — с 38% до 62%
Указанное количество токенов и стоимость охватывают все 1 200 вызовов TypeSafe, использованных для переранжирования 40 шортлистов.
Каждая строка CLERC содержит один правильный фрагмент и 20 отрицательных. В этом руководстве фрагменты из 170 строк объединены в один общий корпус. Для каждого из 40 тестовых запросов BM25 выбирает 30 кандидатов из всего корпуса, а не только из 20 отрицательных примеров конкретной строки. Затем TypeSafe сопоставляет запрос с каждым выбранным кандидатом и переранжирует эти 30 фрагментов.
Для наглядности в этом примере задавался один вопрос на пару. В реальном приложении для одной и той же пары можно задать сразу несколько вопросов в одном вызове. Подробнее см. в руководстве по параллельным вопросам и описании паттерна Speculative Fan-Out.
Что дальше
Те же строительные блоки рассматриваются в других разделах документации TypeSafe:
- Noul — как TypeSafe превращает вопрос «да/нет» в оценку.
- Speculative Fan-Out — как задавать несколько вопросов к одному документу в одном вызове.
- Построчный поиск (Line-by-line Search) — еще один способ поиска по корпусу по смыслу, а не по ключевым словам.