Вызов типизированных функций
Turns natural-language trading requests into calls to ordinary typed functions by mapping function names and closed-set arguments to confidence-aware TypeSafe questions.
Превращает торговые запросы на естественном языке в вызовы обычных типизированных функций, сопоставляя имена функций и замкнутые наборы аргументов с вопросами TypeSafe, возвращающими оценку уверенности.
Когда вы заказываете «большой айс-латте на овсяном молоке без сахара», бариста не записывает ваше предложение целиком. Он отмечает четыре опции на стаканчике. В этом руководстве тот же принцип реализован для торгового API: на вход поступает фраза на естественном языке, а на выходе формируется имя функции и ее аргументы в виде вычисленных перечислений (enum), каждое с оценкой уверенности (confidence).
"plot rolling correlation between nvda and spy for the past month"
    rolling_correlation(symbol='NVDA', benchmark='SPY', window='1mo')   confidence 0.91

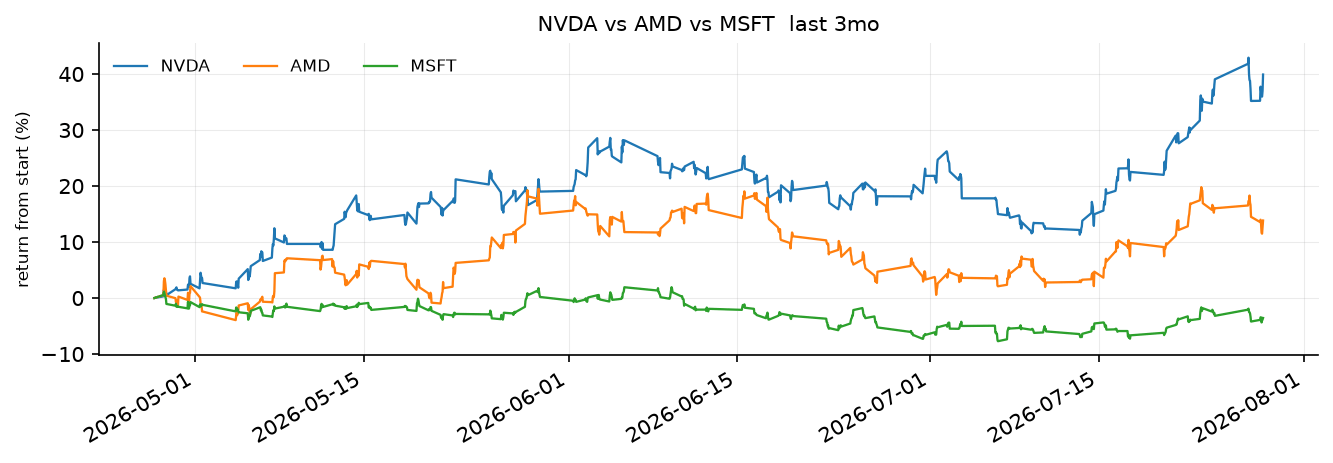
"compare nvda amd and msft over the past three months"
    compare_returns(symbols=['NVDA', 'AMD', 'MSFT'], window='3mo')      confidence 0.94

"show me apple daily with volume"
    plot_price(symbol='AAPL', resolution='1d', include_volume=True)     confidence 0.75

"what tickers do you have"
    list_symbols()                                                     confidence 1.00
Эти вызовы адресуются десяти обычным функциям торгового ассистента. Их аргументы принимают значения из фиксированных списков, поэтому они уже являются типами Literal:
def plot_price(
    symbol: Literal["SPY", "NVDA", "AMD", "AAPL", "MSFT", "TSLA"],
    style: Literal["line", "candles"] = "line",
    resolution: Literal["1m", "5m", "15m", "1h", "1d"] = "15m",
    window: Literal["1d", "1w", "1mo", "3mo"] = "1w",
    include_volume: bool = False,
    moving_average: Literal["9", "20", "50"] | None = None,
    log_scale: bool = False,
): ...
Аргумент, значения которого берутся из фиксированного списка, образует замкнутое множество (closed set). Когда он принимает одно значение из этого списка, к нему применяется вопрос Choice именно по этим значениям, благодаря чему в функцию всегда передается только то значение, которое она способна принять. Сами функции остаются без изменений. Все, что вы добавляете, — это спецификация, описывающая простыми словами значение каждого аргумента. В итоге вы получаете Dispatcher, который можно настроить на собственные функции.
Настройка
pip install ipython polars matplotlib numpy "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/Задайте TYPESAFE_API_KEY. Рядом с этим файлом находятся два модуля: trader.py содержит десять функций и клиент TypeSafe, считывающий ответы из кэша (поэтому повторный рендеринг воспроизводит цифры ниже без вызовов API); dispatch.py содержит код, который читает сигнатуру со спецификацией и выполняет вызов.
import json
from pathlib import Path

from cooksafe import make_playground_link
from dispatch import ROUTE, Dispatcher, closed_sets
from IPython.display import Markdown, display
from trader import TOOLS, client, load

TYPESAFE_MODEL = "jev-1.12"
print(f"{len(TOOLS)} functions over {load().height:,} one-minute bars")10 functions over 156,780 one-minute barsПоиск замкнутых множеств в сигнатурах
Аннотации типов уже сообщают, какие аргументы берутся из фиксированного списка и что входит в каждый список. Функция closed_sets считывает сигнатуру и распределяет эти аргументы по трем формам: choice (Literal, то есть одно значение из списка), set (list[Literal[...]], то есть произвольное их количество) или flag (bool, то есть включено/выключено). Все десять функций определены в trader.py.
for name, fn in TOOLS.items():
    shapes = closed_sets(fn)
    print(
        f"  {name:<20}{len(shapes)}  "
        + ", ".join(f"{a}:{s}" for a, (s, _) in shapes.items())
    )
print(
    f"\n{sum(len(closed_sets(fn)) for fn in TOOLS.values())} fillable arguments in total"
)list_symbols 0
market_summary 1 window:choice
plot_price 7 symbol:choice, style:choice, resolution:choice, window:choice, include_volume:flag, moving_average:choice, log_scale:flag
intraday_pattern 3 symbol:choice, window:choice, metric:choice
compare_returns 3 symbols:set, window:choice, normalize:flag
rolling_correlation 4 symbol:choice, benchmark:choice, window:choice, resolution:choice
summary_stats 2 symbol:choice, window:choice
volatility 3 symbol:choice, window:choice, annualized:flag
top_movers 2 window:choice, direction:choice
drawdown 3 symbol:choice, window:choice, plot:flag
28 fillable arguments in totalФункция top_movers показывает, что именно исключается. Из трех ее аргументов два представляют собой замкнутые множества. Третий, limit, имеет тип int, поэтому для него вопрос не формируется и сохраняется значение по умолчанию (3). Произвольный текст, числа и даты обрабатываются точно так же: никакого вопроса не задается, и функция использует свое значение по умолчанию.
Составление спецификации
Тип Literal предоставляет строки "1mo" и "3mo". Но он не объясняет, что пользователь, написавший «в этом квартале», имеет в виду второе значение. Это объясняет спецификация. Она содержит по вопросу на аргумент, по строке на вариант ответа, описание для каждой функции и еще один вопрос для выбора подходящей функции. Спецификация хранится в spec.json, и LLM может сгенерировать ее по сигнатурам функций.
SPEC = json.loads(Path("spec.json").read_text())
for argument in ("style", "moving_average"):
    print(
        json.dumps(
            {argument: SPEC["functions"]["plot_price"]["arguments"][argument]}, indent=2
        )
){
"style": {
"question": "Does the user want a plain line or candles?",
"stated": "Does the user say how the chart should be drawn, such as a line, candles, or OHLC bars?",
"options": {
"line": "a simple line through the closing prices",
"candles": "a candlestick or OHLC chart, showing each bar's open, high, low and close"
}
}
}
{
"moving_average": {
"question": "How many bars should the moving average cover - nine, twenty, or fifty?",
"stated": "Does the user ask for a moving average or a smoothed line over the candles?",
"options": {
"9": "a nine-bar moving average, a fast one",
"20": "a twenty-bar moving average",
"50": "a fifty-bar moving average, a slow one"
}
}
}Ключи вариантов — это строки, принимаемые функцией, поэтому не требуется обратного сопоставления меток с аргументами. Поле stated делает аргумент опциональным. Это второй вопрос типа «да/нет», проверяющий, упоминается ли вообще данный аргумент в команде. При ответе «нет» аргумент не передается, и применяется значение функции по умолчанию.
Аргумент типа set (множество) получает свой вопрос по одному разу на каждый элемент, где {} заменяется на имя элемента: например, "Does the user want {} in the comparison?" превращается в отдельный вопрос для каждого тикера.
Формулируйте каждый вопрос вокруг смысловой сути, а не конкретных слов пользователя, поскольку сопоставление происходит по смыслу: запрос «is amd tracking nvidia lately» корректно маршрутизируется в rolling_correlation, несмотря на то что ни tracking, ни lately не встречаются в spec.json. Не называйте вопрос по имени параметра — формулировка "Which resolution?" не дает модели никакой смысловой опоры для сопоставления.
Преобразование спецификации в вопросы
Dispatcher однократно строит вопросы на основе спецификации. Затем каждая команда превращается в один запрос, содержащий выбор функции и аргументы каждой функции, а диспетчер считывает только ответы выбранной функции.
assistant = Dispatcher(SPEC, TOOLS, client)
print(f"{len(assistant.questions)} questions per command, among them:")
for qid in (
    "__tool__",
    "plot_price.style",
    "plot_price.style?",
    "compare_returns.symbols.NVDA",
):
    question = assistant.questions[qid]
print(f" {qid:<30}{question['type']:<8}{str(question['instructions'])[:64]}")54 questions per command, among them:
__tool__ choice What is the user asking the trading assistant to do?
plot_price.style choice Does the user want a plain line or candles?
plot_price.style? noul Does the user say how the chart should be drawn, such as a line,
compare_returns.symbols.NVDA noul Does the user want NVDA in the comparison?Выполнение четырнадцати команд
Каждый запрос занимает одну строку, а его confidence (уверенность) отражает наименее уверенное решение, лежащее в основе этого вызова.
COMMANDS = [
    "show nvda 1h",
    "plot rolling correlation between nvda and spy for the past month",
    "when during the day does nvda trade the most",
    "what moved today",
    "what tickers do you have",
    "how did the market do this week",
    "candles for tesla with a 20 period moving average",
    "compare nvda amd and msft over the past three months",
    "how volatile is tsla",
    "biggest losers today",
    "worst drawdown for nvda this quarter, and chart it please",
    "spy stats for the last month",
    "show me apple daily with volume",
    "is amd tracking nvidia lately",
]

CALLS = {command: assistant(command) for command in COMMANDS}
for command, call in CALLS.items():
    print(f'  "{command}"')
    print(
        f"      {str(call):<66}confidence {call.confidence:.2f}"
        f"   tool {call.tool.probability:.2f}"
)"show nvda 1h"
plot_price(symbol='NVDA', resolution='1h') confidence 0.78 tool 1.00
"plot rolling correlation between nvda and spy for the past month"
rolling_correlation(symbol='NVDA', benchmark='SPY', window='1mo') confidence 0.91 tool 1.00
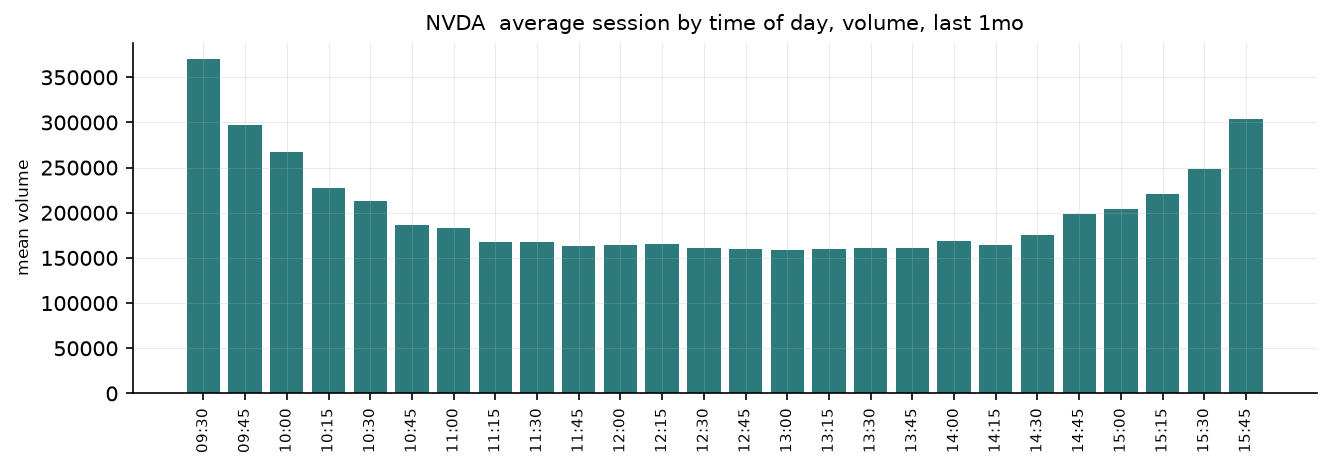
"when during the day does nvda trade the most"
intraday_pattern(symbol='NVDA') confidence 0.53 tool 1.00
"what moved today"
top_movers(window='1d', direction='gainers') confidence 0.90 tool 0.90
"what tickers do you have"
list_symbols() confidence 1.00 tool 1.00
"how did the market do this week"
market_summary(window='1w') confidence 0.96 tool 0.99
"candles for tesla with a 20 period moving average"
plot_price(symbol='TSLA', style='candles', moving_average='20') confidence 0.69 tool 0.97
"compare nvda amd and msft over the past three months"
compare_returns(symbols=['NVDA', 'AMD', 'MSFT'], window='3mo') confidence 0.94 tool 1.00
"how volatile is tsla"
volatility(symbol='TSLA') confidence 0.96 tool 1.00
"biggest losers today"
top_movers(window='1d', direction='losers') confidence 0.98 tool 0.98
"worst drawdown for nvda this quarter, and chart it please"
drawdown(symbol='NVDA', window='3mo', plot=True) confidence 0.84 tool 0.84
"spy stats for the last month"
summary_stats(symbol='SPY', window='1mo') confidence 0.88 tool 0.88
"show me apple daily with volume"
plot_price(symbol='AAPL', resolution='1d', include_volume=True) confidence 0.75 tool 0.85
"is amd tracking nvidia lately"
rolling_correlation(symbol='AMD', benchmark='NVDA') confidence 0.82 tool 0.82Обе длинные команды были распознаны в точности как запрашивалось. Фраза «plot rolling correlation between nvda and spy for the past month» заполнила четыре аргумента из одного предложения. Два из них, symbol и benchmark, выбираются из одного и того же списка шести тикеров, и каждый тикер попал в нужный аргумент, поскольку вопросы четко разграничивают их роли: измеряемый актив, названный первым против второго названного актива, эталона сравнения. Команда «compare nvda amd and msft over the past three months» включила в набор три тикера, исключив остальные три.
Запуск трех из них:
for command in (
    "plot rolling correlation between nvda and spy for the past month",
    "compare nvda amd and msft over the past three months",
    "when during the day does nvda trade the most",
):
    print(f'"{command}"  ->  {CALLS[command]}')
display(CALLS[command].run())"plot rolling correlation between nvda and spy for the past month" -> rolling_correlation(symbol='NVDA', benchmark='SPY', window='1mo')
"compare nvda amd and msft over the past three months" -> compare_returns(symbols=['NVDA', 'AMD', 'MSFT'], window='3mo')
"when during the day does nvda trade the most" -> intraday_pattern(symbol='NVDA')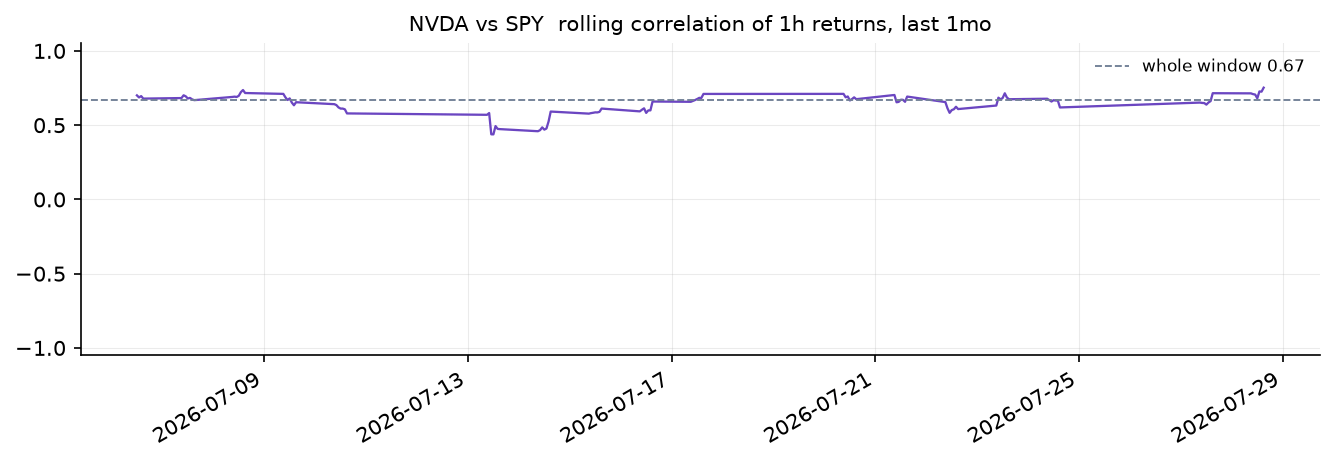
И команды, возвращающие текстовый ответ:
for command in ("how did the market do this week", "biggest losers today"):
    print(f'"{command}"  ->  {CALLS[command]}')
print(CALLS[command].run(), "\n")"how did the market do this week" -> market_summary(window='1w')
the board over 1w
NVDA 254.12 9.62% 389,465,563
AMD 184.20 1.51% 182,740,497
AAPL 258.71 0.97% 223,818,998
SPY 664.86 0.40% 138,617,365
MSFT 451.35 0.26% 113,427,173
TSLA 320.22 -0.97% 266,317,023
"biggest losers today" -> top_movers(window='1d', direction='losers')
top 3 losers over 1d
AMD -0.57% -> 184.20
MSFT 0.67% -> 451.35
AAPL 1.40% -> 258.71Анализ показателя уверенности
confidence сообщает о наименее уверенном суждении в вызове, а не о произведении всех вероятностей, поскольку одного неверного аргумента достаточно, чтобы испортить весь результат. Произведение отвечало бы на другой вопрос («верна ли абсолютно каждая часть») и неизбежно падало бы с ростом числа аргументов, даже если ни одно суждение не вызывает сомнений.
Откуда взялось это число, аргумент за аргументом:
call = CALLS["is amd tracking nvidia lately"]
print(f'"is amd tracking nvidia lately"  ->  {call}   confidence {call.confidence:.2f}')
for name, argument in call.arguments.items():
    top = sorted(argument.distribution.items(), key=lambda kv: -kv[1])[:3]
    shown = "omitted, default stands" if argument.omitted else repr(argument.value)
    print(
        f"  {name:<12}{shown:<26}p {argument.probability:.2f}   "
        + "  ".join(f"{k} {v:.2f}" for k, v in top)
    )
print(f" weakest argument: {call.weakest().name}")"is amd tracking nvidia lately" -> rolling_correlation(symbol='AMD', benchmark='NVDA') confidence 0.82
symbol 'AMD' p 0.87 AMD 0.87 NVDA 0.13 AAPL 0.00
benchmark 'NVDA' p 0.78 NVDA 0.92 AMD 0.08 AAPL 0.00
window omitted, default stands p 0.96
resolution omitted, default stands p 0.99
weakest argument: benchmarkАргументы window и resolution здесь опущены, поскольку слово «lately» (в последнее время) не указывает конкретный период или таймфрейм свечей, поэтому rolling_correlation выполняется со своими собственными значениями по умолчанию: один месяц и часовые бары. Именно для этого и служит вопрос stated. Без него модель была бы вынуждена выбрать какое-то окно и сделала бы это с высокой уверенностью.
Открыть в песочнице
Ссылка ниже содержит одну команду и вопросы для выбранной ею функции: выбор среди описаний десяти функций и четыре аргумента rolling_correlation. Отредактируйте команду в песочнице, и аргументы изменятся вместе с ней.
COMMAND = "plot rolling correlation between nvda and spy for the past month"
picked = CALLS[COMMAND]
playground_link = make_playground_link(
    COMMAND,
    {ROUTE: assistant.questions[ROUTE]}
    | {q: v for q, v in assistant.questions.items() if q.startswith(f"{picked.name}.")},
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Open the command and its questions in the TypeSafe playground]({playground_link})"
    )
)