Классификация с учетом уверенности
Classify SEC annual reports into 75 industry groups with one Choice each, then read the answer's own confidence to decide whether to report that group or the broader division above it.
Классификация годовых отчетов SEC по 75 отраслевым группам с помощью одного вопроса Choice для каждого документа с последующим считыванием собственной уверенности ответа для принятия решения: выводить ли узкую отраслевую группу или более широкое отраслевое подразделение.
Каждая компания, подающая годовой отчет в SEC (Комиссию по ценным бумагам и биржам США), описывает свой бизнес в форме 10-K. В этом кукбуке мы классифицируем эти описания по стандартной отраслевой классификации SIC (Standard Industrial Classification): 75 отраслевых групп, по одному вопросу Choice на каждый документ.
Большинство отчетов классифицируются легко: региональный банк — это региональный банк. Но некоторые сложны: например, компания, которая только что продала один из двух своих сегментов, или стартап, описывающий бизнес, на который он только планирует выйти. Модель обязана выбрать одну группу в любом случае, и внешне ответ для сложного случая ничем не отличается от ответа для простого. Обычно именно на разделение простых и сложных случаев уходят основные ресурсы: привлечение второй модели, цепочки повторных вызовов или ручная проверка человеком.
Вопрос Choice решает это изначально. Наряду с победившим вариантом он возвращает показатель confidence (уверенность): он высок, когда практически вся вероятность сосредоточена на одном варианте, и низок, когда вероятность распределена между несколькими альтернативами. Это единственное число отделяет ответы, которым можно доверять, от тех, которым доверять нельзя.
Что делать с неуверенным ответом, зависит от структуры вашей таксономии. Коды SIC образуют иерархию: отраслевые группы объединяются в более широкие подразделения (divisions). Это позволяет получить надежный ответ почти бесплатно: когда модель не уверена в конкретной группе, возвращается более широкое подразделение, к которому относится эта группа. Широкая категория выводится из узкой автоматически в коде, поэтому второй вызов нейросети не требуется.
На выборке из 60 отчетов пороговое значение уверенности 0.9 делит их ровно пополам. Уверенная половина оказывается точной в 90% случаев; вторая половина — лишь в 40%. Но при агрегации ответов неуверенной половины до уровня подразделения точность возрастает с 40% до 70%. В итоге получается функция classify(), возвращающая метку и степень ее детализации за один API-запрос на документ.
flowchart LR
doc["Раздел 1 'Бизнес'<br/>из отчета 10-K"]
subgraph request["один запрос"]
q["Choice<br/>75 отраслевых групп"]
end
sure{"уверенность<br/>≥ 0.9?"}
grp["вывести отраслевую группу<br/><i>например, 28</i>"]
div["вывести подразделение<br/><i>например, производство</i>"]
doc --> request --> sure
sure -- "да" --> grp
sure -- "нет" --> divНастройка
pip install ipython matplotlib "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/Задайте переменную окружения TYPESAFE_API_KEY. Каждый вызов API кэшируется в json_cache.json, поставляемый вместе с кукбуком, благодаря чему повторный запуск воспроизводит опубликованные числа без реальных обращений к API. Удалите этот файл, чтобы выполнить запросы вживую.
Приведенные ниже числа получены на модели jev-1.12.
import json
from collections import defaultdict
from pathlib import Path

import matplotlib
import matplotlib.pyplot as plt
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Choice, TypeSafeClient

matplotlib.use("Agg")  # рендеринг графиков без дисплея

import os  # noqa: E402

TYPESAFE_MODEL = "jev-1.12"
CONFIDENT = 0.9  # выше этого порога выводится группа, ниже — подразделение

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Построение двух уровней таксономии
Файл sic_codes.tsv содержит официальный перечень отраслей SEC: 444 четырехзначных кода с названиями отраслей. Цифры отражают иерархию: первые две цифры задают основную группу (75 групп от 01 до 99), а диапазоны основных групп формируют 10 подразделений (divisions) — наиболее широкий уровень классификации SIC.
Оба уровня извлекаются из одного файла без вызова нейросетей: коды группируются по первым двум цифрам, а затем сопоставляются с подразделением.
DIVISIONS = [
    (1, 9, "agriculture, forestry and fishing"),
    (10, 14, "mining"),
    (15, 17, "construction"),
    (20, 39, "manufacturing"),
    (40, 49, "transportation, communications and utilities"),
    (50, 51, "wholesale trade"),
    (52, 59, "retail trade"),
    (60, 67, "finance, insurance and real estate"),
    (70, 89, "services"),
    (91, 99, "public administration"),
]

INDUSTRIES: dict[str, str] = {}
for line in Path("sic_codes.tsv").read_text().splitlines()[1:]:
    code, _office, title = line.split("\t")
    INDUSTRIES[code] = title.lower()

GROUPS: dict[str, list[str]] = defaultdict(list)
for code in sorted(INDUSTRIES):
    GROUPS[code[:2]].append(code)


def division(group: str) -> str:
    number = int(group)
    return next(name for low, high, name in DIVISIONS if low <= number <= high)


print(
    f"{len(INDUSTRIES)} industries -> {len(GROUPS)} major groups -> {len(DIVISIONS)} divisions"
)
print(
    f"  group 35 = {division('35')} / {', '.join(INDUSTRIES[c] for c in GROUPS['35'][:3])} ..."
)444 industries -> 75 major groups -> 10 divisions
group 35 = manufacturing / engines & turbines, farm machinery & equipment, lawn & garden tractors & home lawn & gardens equip ...Для вопроса Choice требуется описание каждого варианта ответа. В перечне SEC общее название есть только у 42 из 75 групп. Поэтому каждая группа описывается списком входящих в нее подотраслей:
MAX_NAMED = (
    8  # количество отраслей на группу; достаточно для описания без перегрузки текстом
)


def describe(group: str) -> str:
    umbrella = INDUSTRIES.get(f"{group}00")
    inside = [INDUSTRIES[c] for c in GROUPS[group] if c != f"{group}00"][:MAX_NAMED]
    listed = "; ".join(inside)
    return (
        f"{umbrella} — includes: {listed}"
        if umbrella and listed
        else (umbrella or listed)
    )


print(f"group 20: {describe('20')[:150]}")
print(f"\ngroup 65: {describe('65')[:150]}")group 20: food and kindred products — includes: meat packing plants; sausages & other prepared meat products; poultry slaughtering and processing; dairy product
group 65: real estate — includes: real estate operators (no developers) & lessors; operators of nonresidential buildings; operators of apartment buildings; lessОтчеты компаний
Файл filings.jsonl содержит 60 годовых отчетов 10-K, обрезанных до Раздела 1 «Бизнес» (описание деятельности компании). Объем текстов составляет от 700 до 2200 слов. Каждый отчет содержит реальный отраслевой код SIC, указанный самой компанией при подаче, а также номер регистрации на EDGAR.
FILINGS = [json.loads(line) for line in Path("filings.jsonl").read_text().splitlines()]
example = FILINGS[7]
print(
    f"{len(FILINGS)} filings, {sum(f['words'] for f in FILINGS) // len(FILINGS)} words on average"
)
print(f"\n{example['id']} (filed {example['year']}, accession {example['accession']}):")
print(f"  {example['text'][:230]}...")
print(f" filer's code: {example['sic']} {INDUSTRIES[example['sic']]}")60 filings, 1438 words on average
1389870_2008 (filed 2008, accession 0001079974-09-000155):
Item 1. DESCRIPTION OF BUSINESS. NARRATIVE DESCRIPTION OF THE BUSINESS Across America Financial Services, Inc. is a corporation which was formed under the laws of the State of Colorado on December 1, 2005. Until March 23, 2007, we...
filer's code: 6163 loan brokersОдин вопрос Choice и считывание уверенности
Задается один вопрос Choice, вариантами которого выступают все 75 отраслевых групп. Вся таксономия умещается в одном запросе (Choice надежно масштабируется вплоть до ~240 вариантов).
Ответ содержит поле choice (победившая группа), probabilities (распределение вероятностей по всем 75 группам) и confidence (степень концентрации распределения). Алгоритм анализирует именно confidence, а не сырую вероятность победителя: победа с вероятностью 0.45 при ближайшем конкуренте 0.44 кардинально отличается от 0.45, когда остальные 0.55 равномерно распылены по десяткам вариантов. Метрика confidence точно фиксирует эту разницу.
QUESTION = (
    "Which broad industry does this company operate in? Judge the company's own operations "
    "as this filing describes them."
)


def questions() -> dict:
    return {
        "group": Choice(
            instructions=QUESTION,
            criteria={group: describe(group) for group in sorted(GROUPS)},
        )
    }


@json_cache
def ask(filing_id: str, text: str) -> dict:
    response = client.system_one(
        state=text, questions=questions(), model=TYPESAFE_MODEL
    )
    answer = response.answers["group"]
    return {
        "group": answer.choice,
        "confidence": answer.confidence,
        "probabilities": dict(answer.probabilities),
    }
Возврат группы при уверенности и подразделения при неуверенности
Четыре строки кода ниже задают весь рабочий пайплайн. При значении уверенности 0.9 и выше ответ возвращается как отраслевая группа; ниже 0.9 тот же результат возвращается в виде более общего подразделения.
Каждый отчет гарантированно получает применимую метку. Если модель не уверена в конкретной узкой группе, система не «галлюцинирует» и не выбрасывает ошибку, а возвращает надежную общую категорию.
def classify(filing: dict) -> dict:
    answer = ask(filing["id"], filing["text"])
    sure = answer["confidence"] >= CONFIDENT
    return {
        "level": "group" if sure else "division",
        "label": answer["group"] if sure else division(answer["group"]),
        "confidence": answer["confidence"],
        "group": answer["group"],
    }


def show(filing: dict) -> None:
    result = classify(filing)
    named = describe(result["group"]).split(" — ")[0][:46]
    print(
        f"  {filing['id']:>13}  conf {result['confidence']:.2f}  -> {result['level']:<8} "
        f"{result['label']:<14} (group {result['group']}: {named})"
    )


print("три отчета, в которых модель была абсолютно уверена:")
for f in sorted(FILINGS, key=lambda f: -ask(f["id"], f["text"])["confidence"])[:3]:
    show(f)
print("\nтри отчета, где модель сомневалась:")
for f in sorted(FILINGS, key=lambda f: ask(f["id"], f["text"])["confidence"])[:3]:
show(f)три отчета, в которых модель была абсолютно уверена:
310158_1996 conf 1.00 -> group 28 (group 28: chemicals & allied products)
33416_1998 conf 1.00 -> group 63 (group 63: life insurance; accident & health insurance; h)
352541_1996 conf 1.00 -> group 49 (group 49: electric, gas & sanitary services)
три отчета, где модель сомневалась:
1372167_2013 conf 0.22 -> division manufacturing (group 38: search, detection, navagation, guidance, aeron)
1398633_2009 conf 0.23 -> division wholesale trade (group 50: wholesale-durable goods)
46653_1999 conf 0.29 -> division services (group 87: services-engineering, accounting, research, ma)Показатель уверенности строго коррелирует со сложностью классификации текста. Три отчета с уверенностью 1.00 принадлежат фармпроизводителю, страховщику жизни и энергетической компании. Три отчета внизу списка объективно неоднозначны: два из них описывают стартапы на ранней стадии разработки («планирует действовать как разработчик ПО»), а третья компания управляла двумя разными направлениями и продала одно из них незадолго до подачи отчета. Для них возвращается надежная категория подразделения.
Что дает обобщение ответа
Сравнение двух политик на всех 60 отчетах: принудительно возвращать узкую группу всегда vs возвращать подразделение при уверенности ниже 0.9.
def correct(filing: dict, result: dict) -> bool:
    gold_group = filing["sic"][:2]
    if result["level"] == "group":
        return result["label"] == gold_group
    return result["label"] == division(gold_group)


results = [(f, classify(f)) for f in FILINGS]
sure = [(f, r) for f, r in results if r["level"] == "group"]
unsure = [(f, r) for f, r in results if r["level"] == "division"]

forced = sum(r["group"] == f["sic"][:2] for f, r in results)
broadened = sum(correct(f, r) for f, r in results)

print(f"принудительный выбор группы всегда          {forced}/{len(results)} верно")
print(
    f"  из них в тех {len(sure)}, где была уверенность  "
    f"{sum(r['group'] == f['sic'][:2] for f, r in sure)}/{len(sure)} верно"
)
print(
    f"  и в тех {len(unsure)}, где уверенности не было   "
    f"{sum(r['group'] == f['sic'][:2] for f, r in unsure)}/{len(unsure)} верно"
)
print(
    f"\nс обобщением при сомнениях                   {broadened}/{len(results)} полезных ответов"
)принудительный выбор группы всегда 39/60 верно
из них в тех 30, где была уверенность 27/30 верно
и в тех 30, где уверенности не было 12/30 верно
с обобщением при сомнениях 48/60 полезных ответовТам, где модель была уверена, отраслевая группа верна в 9 случаях из 10. Там, где уверенности не было, прямой выбор группы ошибочен в 60% случаев (точность всего 40%). Обобщение тех же самых ответов до подразделения поднимает полезную точность до 70%.
labels = ["уверена\n(выведена группа)", "не уверена\n(выведено подразделение)"]
forced_split = [
    sum(r["group"] == f["sic"][:2] for f, r in sure) / len(sure),
    sum(r["group"] == f["sic"][:2] for f, r in unsure) / len(unsure),
]
broad_split = [
    sum(correct(f, r) for f, r in sure) / len(sure),
    sum(correct(f, r) for f, r in unsure) / len(unsure),
]

fig, ax = plt.subplots(figsize=(7, 3.6))
x = range(len(labels))
ax.bar(
    [i - 0.19 for i in x],
    forced_split,
    0.38,
    label="всегда указывать группу",
    color="#c8ccd4",
)
ax.bar(
    [i + 0.19 for i in x],
    broad_split,
    0.38,
    label="обобщать при неуверенности",
    color="#3b6ea5",
)
for i, (a, b) in enumerate(zip(forced_split, broad_split)):
    ax.text(i - 0.19, a + 0.02, f"{a:.0%}", ha="center", fontsize=9)
    ax.text(i + 0.19, b + 0.02, f"{b:.0%}", ha="center", fontsize=9)
ax.set_xticks(list(x))
ax.set_xticklabels(
    [f"{lab}\nn={n}" for lab, n in zip(labels, [len(sure), len(unsure)])]
)
ax.set_ylabel("доля точных меток")
ax.set_ylim(0, 1.12)
ax.set_title("Эффект обобщения ответов при низкой уверенности")
ax.legend(frameon=False, loc="upper right")
ax.spines[["top", "right"]].set_visible(False)
plt.tight_layout()
display(fig)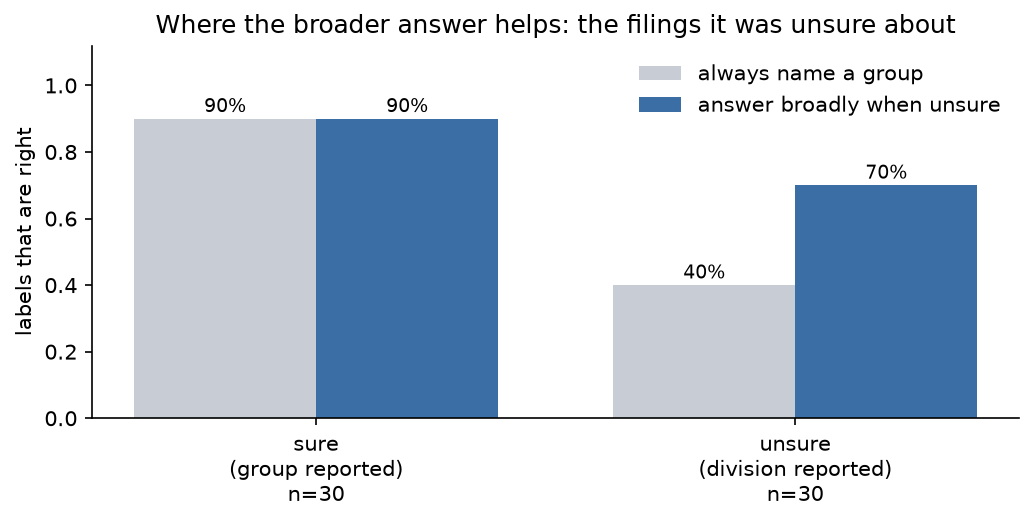
Открыть пример в Playground
Ссылка ниже открывает один из отчетов с вопросом по 75 группам в TypeSafe Playground:
playground_link = make_playground_link(
    example["text"], questions(), models=[TYPESAFE_MODEL]
)
display(
    Markdown(
        f"🔗 [Открыть отчет и вопросы в TypeSafe playground]({playground_link})"
    )
)