Сопоставление сущностей графа знаний
Decides which of 450 candidate pairs from two beer catalogues describe the same product. One TypeSafe Score question carries the whole decision, because its three levels are the three things you can do with a pair: merge it, leave it unlinked, or hand it to a curator. There is no threshold to fit, a…
Определение того, какие из 450 пар-кандидатов из двух каталогов пива описывают один и тот же продукт. Один вопрос TypeSafe Score решает всю задачу, поскольку три его уровня соответствуют трем возможным действиям: объединить, оставить без связи или передать на проверку куратору. Нет необходимости подбирать пороговые значения вручную, а три сопутствующих вопроса Noul в том же запросе сообщают куратору, по каким именно полям данные расходятся.
Ключевая проблема в графах знаний — определение того, дублирует ли новая сущность уже существующую, особенно когда в качестве источника доступны только разрозненные тексты на естественном языке. Для заданных пар потенциальных дубликатов один вопрос TypeSafe Score определяет, является ли пара дубликатом или требует детального анализа куратором.
Представьте, что два источника данных содержат пересекающиеся наборы одних и тех же объектов, и вам нужно сопоставить запись с одной стороны с соответствующей записью с другой стороны. В графах знаний такие записи называются сущностями (entities), и они содержат зафиксированные факты о каждом объекте. Быстрый и грубый первичный проход уже сопоставил два источника и отобрал 450 пар-кандидатов, заслуживающих пристального внимания. Остается вынести решение по каждой паре.
Ошибочное объединение двух разных сущностей — гораздо более дорогая ошибка, поскольку теперь каждый факт об обеих сущностях начинает описывать объединенную сущность, а все связанные связи переносятся вместе с ней. Отмена такого объединения впоследствии требует кропотливого выяснения, откуда взялся каждый факт. Пропуск совпадения приводит лишь к сохранению дубликата. Поэтому алгоритму вынесения решений требуется третий вариант: пары, которые небезопасно объединять автоматически, но и нельзя просто отбросить.
Решение формулируется как вопрос Score с отдельным уровнем для каждого из трех исходов:
- different product (разные продукты) — оставить две сущности не связанными;
- related, but possibly not the same (связанные, но, возможно, не одинаковые) — передать куратору-человеку для принятия решения;
- same product (один и тот же продукт) — объединить сущности.
Мы используем вопрос типа Score, потому что хотим сопоставить семантическую метку (критерии оценки) непосредственно каждому исходу, включая промежуточный. Вопрос Noul мог бы решить эту задачу лишь косвенно через пороговую фильтрацию числовых вероятностей, а вопрос Choice потерял бы естественную упорядоченность трех исходов.
Затем для каждого поля сущности, которое мы хотим проанализировать, в том же самом запросе отправляются вопросы Noul о том, совпадают ли эти поля. Эти вопросы Noul предоставляют детализированную информацию для куратора, если итоговая оценка попадает между крайними уровнями шкалы.
В результате вы получаете функцию route(), которая принимает пару-кандидата и возвращает один из трех исходов без необходимости подбирать пороги под свои данные.
flowchart LR
    PAIR["одна пара кандидатов<br/><i>обе сущности, одно состояние</i>"] --> CALL

    subgraph CALL["один запрос, четыре вопроса"]
        direction TB
        S["<b>Score:</b> как соотносятся продукты?<br/>· разные продукты<br/>· похожие, но не факт<br/>· один и тот же продукт"]
        N["<b>Nouls:</b> по одному на каждое поле<br/>· совпадает название?<br/>· совпадает пивоварня?<br/>· совпадает сорт/стиль?"]
        S ~~~ N
    end

    S --> R{"округление до<br/>ближайшего уровня"}
    R -->|"разные"| DROP["оставить без связи"]
    R -->|"одинаковые"| M["утвердить sameAs"]
    R -->|"связанные"| Q["очередь куратора"]
    N -.->|"по какому полю<br/>не сошлись"| Q
Настройка
pip install matplotlib ipython "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/Задайте TYPESAFE_API_KEY. Каждый вызов кэшируется в json_cache.json, поставляемый вместе с кукбуком, поэтому повторный запуск воспроизводит опубликованные числа без реальных обращений к API. Удалите этот файл для выполнения живых запросов.
Приведенные ниже показатели получены на модели jev-1.12.
import json
import os
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

import matplotlib
import matplotlib.pyplot as plt
from cooksafe import JsonCache, make_playground_link
from IPython.display import Markdown, display
from typesafe_sdk import Noul, Score, TypeSafeClient

matplotlib.use("Agg")  # рендеринг без GUI

TYPESAFE_MODEL = "jev-1.12"
MAX_WORKERS = 6  # небольшой пул потоков для соблюдения рейт-лимитов

client = TypeSafeClient(
    api_key=os.environ.get(
        "TYPESAFE_API_KEY", "cache-only"
    ),
    base_url=os.environ.get("TYPESAFE_ENDPOINT"),
    timeout=120.0,
)
json_cache = JsonCache(Path("json_cache.json"))
Загрузка пар кандидатов
Пары взяты из публичного бенчмарка Beer коллекции Magellan: два каталога пива, спарсенных с разных сайтов и предварительно отфильтрованных до 450 пар-кандидатов. Каждая сущность содержит четыре поля: название (name), пивоварня (brewery), сорт (style) и крепость (alcohol content). Каждая пара также содержит эталонный ответ бенчмарка known_same_as.
Текст оставлен без предобработки: сущности HTML, апострофы в виде отдельных слов и артефакты кодировок сохранены как есть.
На каждую пару отправляется ровно один запрос, поэтому расходы масштабируются строго пропорционально количеству переданных пар, а не общему объему исходных баз данных.
PAIRS = json.loads(Path("candidate_pairs.json").read_text(encoding="utf-8"))
BY_ID = {pair["id"]: pair for pair in PAIRS}

print(f"{len(PAIRS)} candidate pairs. The first one, as the model will see it:")
print(json.dumps({k: PAIRS[0][k] for k in ("entity_a", "entity_b")}, indent=2)[:420])450 candidate pairs. The first one, as the model will see it:
{
"entity_a": {
"name": "C N Red Imperial Red Ale",
"brewery": "Redwood Lodge",
"style": "American Amber / Red Ale",
"abv": "8.10 %"
},
"entity_b": {
"name": "Kinetic Infrared Imperial Red Ale",
"brewery": "Kinetic Brewing Company",
"style": "American Strong Ale",
"abv": "9.30 %"
}
}Один вопрос Score и три вопроса Noul на каждую пару
Обе сущности помещаются в единое состояние как entity_a и entity_b, поэтому вопросы задаются о паре, а не о каждой стороне по отдельности. Все четыре вопроса передаются в одном запросе.
Три описания уровней ниже полностью задают правило классификации: каждый уровень соответствует конкретному результату. В коде нет никаких искусственных численных порогов. Эти описания можно составить до того, как вы увидите хотя бы один ответ модели.
Средний уровень требует наиболее точной формулировки: он охватывает вариации, спецвыпуски и названия, которые могут относиться к любому из продуктов. Благодаря этому такие пары направляются куратору вместо ошибочного слияния или отбрасывания.
Словарь OUTCOME задает названия трех исходов. Исход слияния назван assert sameAs, так как предикат sameAs является стандартом для обозначения эквивалентности сущностей в графах знаний.
Для трех полей задаются вопросы Noul: название, пивоварня и стиль. Крепость напитка (алкоголь) не требует нейросетевого вопроса, так как сравнение чисел — это простая арифметика, реализуемая в коде.
LEVELS = [
    "They describe two different products.",
    "They describe closely related products that may or may not be the same one: "
    "a variant, a special edition, or a name that could plausibly refer to either.",
    "They describe one and the same product.",
]
OUTCOME = {0: "leave unlinked", 1: "curator queue", 2: "assert sameAs"}

QUESTIONS = {
    "link_state": Score(
        instructions="How do the two entity descriptions relate as products?",
        criteria=LEVELS,
    ),
    "same_name": Noul(
        instructions="Do the two entities state the same beer name?",
    ),
    "same_brewery": Noul(
        instructions="Are the two entities from the same brewery?",
    ),
    "same_style": Noul(
        instructions="Do the two entities describe the same beer style?",
    ),
}


@json_cache
def score(pair_id: str) -> dict:
    """Один запрос на пару-кандидата -> оценка score плюс три ответа noul."""
    pair = BY_ID[pair_id]
    response = client.system_one(
        state={"entity_a": pair["entity_a"], "entity_b": pair["entity_b"]},
        questions=QUESTIONS,
        model=TYPESAFE_MODEL,
    )
    link = response.answers["link_state"]
    return {
        "score": link.score,
        "probabilities": link.probabilities,
        "confidence": link.confidence,
        "properties": {
            k: response.answers[k].noul for k in QUESTIONS if k != "link_state"
        },
        "input_tokens": response.usage.input_tokens or 0,
        "output_tokens": response.usage.output_tokens or 0,
    }


def route(score_value: float) -> str:
    """Полное правило маршрутизации: ближайший целочисленный уровень определяет исход."""
    return OUTCOME[min(int(score_value + 0.5), len(LEVELS) - 1)]


def show(pair_id: str) -> None:
    pair, result = BY_ID[pair_id], score(pair_id)
    print(
        f"{pair_id}  score {result["score"]:.2f}  confidence {result["confidence"]:.2f}"
        f"  ->  {route(result["score"])}"
    )
    for side in ("entity_a", "entity_b"):
        e = pair[side]
        print(f"    {e["name"][:44]:<46}{e["brewery"][:30]:<32}{e["style"][:22]}")
    nouls = result["properties"]
    print(
        f"    name {nouls["same_name"]:.2f}   brewery {nouls["same_brewery"]:.2f}   "
        f"style {nouls["same_style"]:.2f}"
    )
Пример обработки четырех характерных пар: c446 — один продукт, c427 — два разных продукта. Две другие пары попадают в средний уровень по разным причинам: у c100 одинаковые название и пивоварня, но формулировка стиля отличается в источниках; у c428 сравнивается базовый сорт пива с его фруктовой модификацией.
for pair_id in ("c446", "c427", "c100", "c428"):
    show(pair_id)
print()c446 score 1.94 confidence 0.92 -> assert sameAs
Thomas Hooker Old Marley Barleywine Thomas Hooker Brewing Company American Barleywine
Thomas Hooker Old Marley Barleywine Thomas Hooker Brewing Company Barley Wine
name 0.97 brewery 0.99 style 0.81
c427 score 0.03 confidence 0.95 -> leave unlinked
Frost Quake Bourbon Barrel Aged Barley Wine Wellington County Brewery American Barleywine
Lompoc Bourbon Barrel Aged Proletariat Red A Lompoc Brewing Amber Ale
name 0.02 brewery 0.09 style 0.08
c100 score 1.30 confidence 0.27 -> curator queue
Belle Gueule Rousse Brasseurs R.J. American Amber / Red A
Belle Gueule Rousse Brasseurs RJ Amber Lager/Vienna
name 0.95 brewery 0.94 style 0.35
c428 score 1.10 confidence 0.77 -> curator queue
Ambleside Amber Ale Bridge Brewing Company American Amber / Red A
Bridge Ambleside Amber Ale - Pomegranate & G Bridge Brewing Company Amber Ale
name 0.63 brewery 0.98 style 0.74Маршрутизация всех пар-кандидатов
# 450 пар-кандидатов, по одному запросу на каждую
with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
    scored = list(pool.map(lambda pair: score(pair["id"]), PAIRS))

scores = [result["score"] for result in scored]
by_outcome: dict[str, list[str]] = {name: [] for name in OUTCOME.values()}
for pair, s in zip(PAIRS, scores):
    by_outcome[route(s)].append(pair["id"])

SURFACE, INK, INK2, MUTED = "#fcfcfb", "#0b0b0b", "#52514e", "#898781"
GRID, AXIS, BLUE, ORANGE = "#e1e0d9", "#c3c2b7", "#2a78d6", "#eb6834"

BINS, TOP = 20, len(LEVELS) - 1
counts = [0] * BINS
for s in scores:
    counts[min(int(s / TOP * BINS), BINS - 1)] += 1
centers = [(i + 0.5) / BINS * TOP for i in range(BINS)]
queued = [c if route(x) == "curator queue" else 0 for c, x in zip(counts, centers)]
settled = [c if route(x) != "curator queue" else 0 for c, x in zip(counts, centers)]

fig, ax = plt.subplots(figsize=(7.2, 3.6), facecolor=SURFACE)
ax.set_facecolor(SURFACE)
for side in ("top", "right"):
    ax.spines[side].set_visible(False)
for side in ("left", "bottom"):
    ax.spines[side].set_color(AXIS)
ax.tick_params(colors=MUTED, labelcolor=INK2, labelsize=9)
ax.set_axisbelow(True)
ax.grid(axis="y", color=GRID, linewidth=0.8)
ax.bar(
    centers, settled, width=TOP / BINS * 0.9, color=BLUE, label="автоматически разрешенные"
)
ax.bar(
    centers, queued, width=TOP / BINS * 0.9, color=ORANGE, label="переданные куратору"
)
for edge in (0.5, 1.5):
    ax.axvline(edge, color=INK2, linewidth=1, linestyle="--")
ax.set_xticks([0, 0.5, 1, 1.5, 2])
ax.set_xticklabels(["0\nразные", "0.5", "1\nпохожие", "1.5", "2\nодинаковые"])
ax.set_xlabel("оценка для пары (score)", color=INK2, fontsize=9)
ax.set_ylabel("кандидатные пары", color=INK2, fontsize=9)
ax.set_title(
    f"{len(PAIRS)} пар кандидатов, оцененных по одному разу",
    loc="left",
    color=INK,
    fontsize=11,
)
ax.legend(frameon=False, labelcolor=INK2, fontsize=9)
display(fig)
plt.close(fig)

for name in ("assert sameAs", "curator queue", "leave unlinked"):
    n = len(by_outcome[name])
print(f"{name:<16}{n:>5} ({n / len(PAIRS):>5.1%})")assert sameAs 40 ( 8.9%)
curator queue 50 (11.1%)
leave unlinked 360 (80.0%)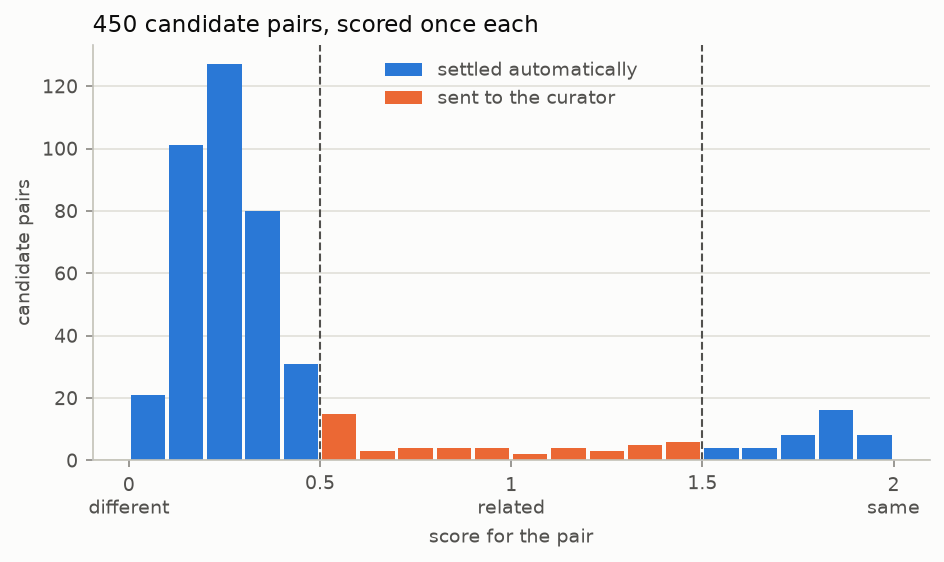
Два пороговых значения, в которых route() меняет ответ, — это точки отсечения (0.5 и 1.5). Большинство пар классифицируются автоматически: 360 получают оценку ниже 0.5, а 40 — выше 1.5. На долю куратора остается всего 50 пограничных пар (11.1%).
В этом наборе оценки не распределяются исключительно по целым числам. Большинство группируется около 0.25: у двух сортов пива может быть одинаковое название стиля или схожее оформление пивоварни, поэтому модель выделяет промежуточному уровню некоторую долю вероятности. Судьбу пары решает то, по какую сторону отсечения она оказалась.
Точки отсечения 0.5 и 1.5 не требуют настройки: обе естественным образом следуют из формулировок критериев уровней. Изменяя формулировку среднего уровня, вы можете гибко балансировать объем ручной работы куратора и точность автоматического связывания.
Открыть пример в Playground
Ссылка ниже открывает пару c428 в TypeSafe Playground: оценка составила 1.10, и пара была передана куратору. Здесь сопоставляются Ambleside Amber Ale и Bridge Ambleside Amber Ale - Pomegranate & Galena Hops от одной и той же пивоварни с одинаковой крепостью.
playground_link = make_playground_link(
    {"entity_a": BY_ID["c428"]["entity_a"], "entity_b": BY_ID["c428"]["entity_b"]},
    QUESTIONS,
    models=[TYPESAFE_MODEL],
)
display(
    Markdown(
        f"🔗 [Открыть эту пару и вопросы в TypeSafe Playground]({playground_link})"
    )
)