Каскадное извлечение данных (SDE Cascade)
Uses a 2-stage structured-data-extraction cascade (mini → verify → reasoning) to get most of the quality of a big reasoning model at a fraction of the cost.
Использование двухэтапного каскада извлечения структурированных данных (mini → верификация → reasoning), позволяющего получить качество большой рассуждающей модели за малую часть ее стоимости.
- Обзор
- Большие рассуждающие модели (reasoning models) отлично извлекают структурированные данные, но работают медленно и стоят дорого.
- Маленькие модели стоят дешево, но совершают ошибки.
- Каскад позволяет получить большую часть качества за малую часть стоимости.
- Используемые модели и их стоимость ($ за 1 млн токенов, вход / выход; стандартные тарифы по состоянию на 15 сентября 2026 г.):
- уровень 0 (mini):
gpt-5.4-mini— $0.75 / $4.50 - уровень 1 (reasoning):
gpt-5.5— $5.00 / $30.00 (примерно в 7 раз дороже mini) - верификатор: TypeSafe
jev-1.12— $0.042 / $0.00 (выходные токены бесплатны; опубликованные тарифы Jev)
- уровень 0 (mini):
- Алгоритм
- Извлечение с помощью дешевой/маленькой модели.
- Верификация с помощью примитивов TypeSafe: набор вопросов типа да/нет для каждого поля («вопрос Noul»), например: «отсутствует ли это значение в источнике?», «взято ли оно из постороннего текста?», каждый из которых возвращает P(что-то не так).
- Эскалация к дорогой модели рассуждений, если срабатывает сигнал верификатора; в противном случае сохраняется дешевый ответ.
- Содержание руководства
- Подробный разбор одного реального примера от начала до конца, а затем демонстрация баланса затрат и качества на 100 промптах.
- Примечание: оба уровня извлечения используют обычный текстовый режим OpenAI.
- Мы не используем structured outputs, tool calls или json mode, потому что:
- ошибка следования схеме — это не та ошибка, которой мы ждем от LLM (для этого легко создать синтетические данные);
- если LLM не способна соблюсти схему, она, как правило, фундаментально запуталась во входных данных, поэтому принудительное декодирование по схеме не решает суть проблемы;
- тем не менее мы рекомендуем попробовать эти режимы самостоятельно!
Настройка
- Установите зависимости (клиент верификатора TypeSafe загружается из индекса пакетов TypeSafe):
BASH THEME={NULL}
api.wedstack.ru/v1
pip install openai datasets jsonschema ipython "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/- Затем задайте переменные окружения
OPENAI_API_KEYиTYPESAFE_API_KEY:
PYTHON THEME={NULL}
api.wedstack.ru/v1
import json
import os
from pathlib import Path

import jsonschema
from cooksafe import JsonCache, make_playground_link
from datasets import load_dataset
from IPython.display import Markdown, display
from openai import OpenAI
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

MINI = "gpt-5.4-mini"  # rung 0: cheap + fast
REASONING = "gpt-5.5"  # rung 1: strong, run with reasoning_effort="high"
TS_MODEL = "jev-1.12"  # the TypeSafe verifier model
FIRE_T = 0.7  # escalate if any per-field P(wrong) exceeds this; also the "<== FIRES" display marker

oai = OpenAI()

ts = TypeSafeClient(api_key=os.environ["TYPESAFE_API_KEY"], timeout=30.0)
Шаг 1: Данные
Мы выбираем датасет из HuggingFace под названием scrapegraphai:
PYTHON THEME={NULL}
api.wedstack.ru/v1
SCRAPEGRAPHAI_REVISION = "4bb9fba1dff9181c5acdb60a5a26fea62fa54fe9"
row = load_dataset(
    "scrapegraphai/scrapegraphai-100k",
    revision=SCRAPEGRAPHAI_REVISION,
    split="train",
)[516]
schema = json.loads(row["schema"])
prompt = row["prompt"]
content = row["content"]

print(
    f"""
PROMPT
===========
{prompt}

SCHEMA
===========
{json.dumps(schema, indent=2)}

CONTENT
===========
{content}
""".strip()
)
TEXT EXPANDABLE THEME={NULL}
api.wedstack.ru/v1
PROMPT
===========
Find registration open date fall semester for New York University in New York, NY for the 2024-2025 school year.
SCHEMA
===========
{
"properties": {
"registration_open_date": {
"description": "The date that registration opens for the fall semester. MUST be in the format mm/dd/yyyy. For example, for a college in the 2024-2025 school year, it might be something like 09/05/2024. Return a blank string if you are unsure.",
"title": "Registration Open Date",
"type": "string"
},
"description": {
"description": "A brief description of the registration open date. For example, 'Registration opens for the fall semester'.",
"title": "Description",
"type": "string"
}
},
"required": [
"registration_open_date",
"description"
],
"title": "RegistrationOpen",
"type": "object"
}
CONTENT
===========
Skip to content Skip to current page navigation
[ ](https://www.nyu.edu/)
Search Site
[ ](https://www.nyu.edu/)
* [ Academics](https://www.nyu.edu/academics.html)
* [ Admissions](https://www.nyu.edu/admissions.html)
* [ Research](https://www.nyu.edu/research.html)
* [ University Life](https://www.nyu.edu/life.html)
* [ About](https://www.nyu.edu/about.html)
All NYU
# Mobile Navigation
[ ](https://www.nyu.edu/)
Search Site
* [Academics](https://www.nyu.edu/academics.html)
* [Admissions](https://www.nyu.edu/admissions.html)
* [Research](https://www.nyu.edu/research.html)
* [University Life](https://www.nyu.edu/life.html)
* [About](https://www.nyu.edu/about.html)
All NYU
Info for
* Back to main menu
* Info for
* [Students](https://www.nyu.edu/students.html)
* [Faculty](https://www.nyu.edu/faculty.html)
* [Alumni](https://www.nyu.edu/alumni.html)
* [Employees](https://www.nyu.edu/employees.html)
* [Community](https://www.nyu.edu/community.html)
[Log In](http://home.nyu.edu/)
Info for
* [Students](https://www.nyu.edu/students.html)
* [Faculty](https://www.nyu.edu/faculty.html)
* [Alumni](https://www.nyu.edu/alumni.html)
* [Employees](https://www.nyu.edu/employees.html)
* [Community](https://www.nyu.edu/community.html)
[Log In](https://home.nyu.edu/)
Search Site Search
# Events Calendar
Search Events
Apply Reset
* [About the Events Calendar ](https://www.nyu.edu/employees/resources-and-services/media-and-communications/digital-communications/university-events-calendar.html)
* [Events Calendar Tutorial ](https://www.nyu.edu/employees/resources-and-services/media-and-communications/digital-communications/university-events-calendar/tutorials.html)
* [Report issue or provide feedback ](https://nyu.service-now.com/sp?id=sc_cat_item&sys_id=7698dd2a98bcf4004c8c03063d84e274)
Search Filters Calendar
New York University
Equal Opportunity and Non-Discrimination at NYU - New York University is committed to maintaining an environment that encourages and fosters respect for individual values and appropriate conduct among all persons. In all University spaces--physical and digital--programming, activities, and events are carried out in accordance with applicable law as well as University policy, which includes but is not limited to its Non-Discrimination and Anti-Harassment Policy.
Unless otherwise noted, all content copyright New York University. All rights reserved.
* [Search](https://search.nyu.edu/)
* [Campus Map](https://www.nyu.edu/map.html)
* [Events](https://events.nyu.edu/)
* [Contact Us](https://www.nyu.edu/contact-us.html)
* [Give](https://www.nyu.edu/about/giving.html)
* [Copyright & Fair Use](https://www.nyu.edu/copyright-and-fair-use.html)
* [Privacy](https://www.nyu.edu/privacy.html)
* [Accessibility](https://www.nyu.edu/accessibility.html)
* [Feedback](https://www.nyu.edu/#feedback.html)
* [New York Campus](https://www.nyu.edu/)
* [Abu Dhabi Campus](https://nyuad.nyu.edu/)
* [Shanghai Campus](https://shanghai.nyu.edu/)
* [](https://facebook.com/)
* [](https://linkedin.com/)
* [](https://x.com/)
* [](https://instagram.com/)
* [](https://youtube.com/)- Данная строка представляет собой страницу календаря мероприятий NYU ("Fall 2024 Census Date"):
- схема запрашивает только два поля:
registration_open_dateиdescription; - парсинг страницы захватил только навигацию календаря и стандартный шаблонный текст: даты регистрации и описания на странице нет;
- обратите внимание: описание поля
descriptionв схеме даже содержит пример ("Registration opens for the fall semester");
- схема запрашивает только два поля:
- корректный экстрактор должен отказаться придумывать значения полей, которых нет на странице;
- давайте посмотрим, справится ли маленькая модель!
Шаг 2: Извлечение с помощью модели mini (текстовый режим)
- примечание:
gpt-5.4-miniведет себя крайне стохастично на этом тексте — даже приtemperature=0она придумывает разноеdescriptionпрактически при каждом запуске. Для обеспечения воспроизводимости мы жестко задали один типичный пример галлюцинации, который далее разбирается в ноутбуке (и который верификатор отмечает с P(wrong) > 0.8). В рабочем коде вы бы напрямую вызывалиextract(MINI, prompt, schema, content, temperature=0).
PYTHON EXPANDABLE THEME={NULL}
api.wedstack.ru/v1
EXTRACT_SYSTEM = (
    "You extract structured data from documents. Return only values supported by the text. "
    "Follow any value format specified by the schema or its field descriptions."
)


# LLM and TypeSafe calls are cached to ``json_cache.json``, which ships with the cookbook, so
# re-rendering reproduces the published results with no API spend; delete the file to re-run live.
json_cache = JsonCache(Path("json_cache.json"))


@json_cache
def extract(
    model: str,
    prompt: str,
    schema: dict,
    content: str,
    *,
    reasoning_effort: str | None = None,
    temperature: float | None = None,
) -> dict:
    user = (
        f"{prompt}\n\nReturn ONLY a JSON object matching this JSON Schema:\n"
        f"{json.dumps(schema, indent=2)}\n\nDocument:\n{content}"
    )
    kwargs = {
        "model": model,
        "messages": [
            {"role": "system", "content": EXTRACT_SYSTEM},
            {"role": "user", "content": user},
        ],
    }
    if reasoning_effort:
        kwargs["reasoning_effort"] = reasoning_effort
    if temperature is not None:
        kwargs["temperature"] = temperature
    text = oai.chat.completions.create(**kwargs).choices[0].message.content
    # The prompt asks for ONLY a JSON object, so parse the reply as-is -- no regex fishing a
    # substring out of a malformed reply. If ``json.loads`` fails, treat it as an empty extraction
    # (the record-level analog of NaN): every field reads as absent, which the verifier flags and the
    # gate escalates -- the safe direction. Schema-following errors are rare here (see the overview).
    try:
        return json.loads(text)
    except (ValueError, json.JSONDecodeError):
        return {}


# Hard-coded canonical fabrication (see note above); a real pipeline would use extract(MINI, prompt, schema, content, temperature=0).
mini_record = {
    "registration_open_date": "",
    "description": "Registration opens for the fall semester",
}
print("mini extraction:\n", json.dumps(mini_record, indent=2))

# The record is a perfect fit for the JSON Schema -- and still wrong. Schema validation is necessary
# but not sufficient: it catches structural errors, never semantic ones. That gap is the whole point.
print("\nschema-valid:", jsonschema.Draft202012Validator(schema).is_valid(mini_record))
PLAINTEXT
api.wedstack.ru/v1
mini extraction:
 {
  "registration_open_date": "",
  "description": "Registration opens for the fall semester"
}

schema-valid: True- Запись соответствует схеме (строка выше выводит
True), но при этом ошибочна:registration_open_dateоставлена пустой, что соответствует странице, на которой дата отсутствует;- однако
descriptionсфабриковано: страница нигде не описывает дату регистрации, поэтому mini придумывает правдоподобное значение. Она может повторить пример из схемы ("Registration opens for the fall semester") или написать что-то вроде "...was not found in the document"; - валидация через JSON Schema не способна обнаружить такую ошибку. Дешевая модель генерирует уверенные, валидные по структуре галлюцинации, и выявление подобных ошибок — прямая задача семантического верификатора.
Шаг 3: Верификация с помощью TypeSafe
- в качестве верификатора выступает TypeSafe; для каждого поля мы формируем вопрос
Noul:- точный вопрос да/нет, сформулированный так, чтобы
trueозначало наличие ошибки (необходимость эскалации);
- точный вопрос да/нет, сформулированный так, чтобы
- TypeSafe возвращает калиброванное значение
noul=P(true)по каждому вопросу за один вызовsystem_one; - набор вопросов включает:
- одну общую оценку
__overall__::judge(«следует ли эскалировать эту запись?»). Мы вычисляем и выводим ее для сопоставления общей оценки записи с детальными оценками отдельных полей, однако решающий гейт на Шаге 4 ее не использует — решение об эскалации принимается на основе набора полей; - набор проверок по каждому полю:
- непустые поля проходят полный спектр проверок;
- пустые поля (null / "" / []) проверяются только вопросом
absence_wrong;
- (полный конвейер также включает проверку
spuriousдля контейнеров и общую оценкуdifficulty; здесь они опущены для наглядности);
- одну общую оценку
- Подход TypeSafe: декомпозиция
- Обратите внимание, как все программно декомпозировано — в этом заключается подход TypeSafe.
- Декомпозиция максимизирует интеллектуальный потенциал каждого промпта и делает алгоритм гибко настраиваемым и интерпретируемым.
PYTHON EXPANDABLE THEME={NULL}
api.wedstack.ru/v1
# metric -> (question, NoulCriteria)
MAIN_QUESTIONS = {
    "name_desc_mismatch": (
        "Does the `extracted_field` fail to match the field at `path` or the `description` in the "
        "`field_spec`? If the `description` is empty, judge against the `path` alone.",
        NoulCriteria(
            true="the `extracted_field` does not match the field name or its `description`",
            false="the `extracted_field` matches the field name and `description`",
        ),
    ),
    "type_mismatch": (
        "Does the `extracted_field` violate the `type` declared in the `field_spec`?",
        NoulCriteria(
            true="the `extracted_field` violates the declared `type`",
            false="the `extracted_field` conforms to the declared `type`",
        ),
    ),
    "unreasonable": (
        "Is the `extracted_field` one that a reasonable person would not have extracted for this "
        "`field_spec`?",
        NoulCriteria(
            true="a reasonable person would not have extracted this value",
            false="the extraction is reasonable",
        ),
    ),
    "hallucinated": (
        "Is the `extracted_field` unsupported by, or absent from, the source text?",
        NoulCriteria(
            true="the `extracted_field` is a hallucination -- not supported by, or absent "
            "from, the source text",
            false="the `extracted_field` is supported by the source text",
        ),
    ),
    "off_target": (
        "Does the source text fail to genuinely report the thing the `field_spec` describes, so the "
        "value was pulled from incidental text?",
        NoulCriteria(
            true="the source does not genuinely provide this field -- the value was pulled "
            "from incidental text",
            false="the source genuinely reports this field",
        ),
    ),
    "incomplete": (
        "Does the `extracted_field` fail to capture a value the source supports (note whether the "
        "`field_spec` is `required`)?",
        NoulCriteria(
            true="the field is wrongly empty, null, or missing a value the source supports",
            false="the field captures the value the source supports",
        ),
    ),
    "format_violation": (
        "Does the `extracted_field` violate the format or constraints implied by the `description`, "
        "the schema `type`, and the extraction instructions (e.g. date format, units, enum membership)?",
        NoulCriteria(
            true="the `extracted_field` violates the implied format or constraints",
            false="the `extracted_field` satisfies the format and constraints",
        ),
    ),
}
ABSENCE_QUESTION = (
    "The `extracted_field` is empty, null, or an empty collection. Does the source text contain the "
    "information the `field_spec` describes, making the empty result wrong?"
)
ABSENCE_CRITERIA = NoulCriteria(
    true="a value was wrongly omitted", false="returning nothing is correct"
)

# The pipeline also asks one holistic, whole-record head: "should this be escalated?"
OVERALL_JUDGE = (
    "Is this extracted record an incorrect extraction -- some value unsupported by the source or "
    "not conforming to the schema, required information missing or wrong, or some field hallucinated -- "
    "so it should be escalated to a smarter model?"
)
OVERALL_JUDGE_CRITERIA = NoulCriteria(
    true="the record is an incorrect extraction",
    false="the record is a correct extraction",
)


def is_empty(v) -> bool:
    return v is None or (isinstance(v, (str, list, dict)) and len(v) == 0)


def field_spec(name: str) -> dict:
    """Minimal spec pulled from the schema (unwrapping anyOf/null for optional fields)."""
    p = schema["properties"][name]
    branches = p.get("anyOf") or []
    typ = p.get("type") or next(
        (b["type"] for b in branches if b.get("type") != "null"), "unknown"
    )
    return {
        "path": name,
        "type": typ,
        "description": p.get("description", ""),
        "required": name in schema.get("required", []),
    }


def build_questions(record: dict) -> dict[str, Noul]:
    """The verify question set: one holistic ``__overall__::judge`` head plus a per-field battery,
    keyed ``field::metric`` (mirrors build_verify_prompts)."""
    questions: dict[str, Noul] = {
        "__overall__::judge": Noul(
            instructions=OVERALL_JUDGE, criteria=OVERALL_JUDGE_CRITERIA
        ),
    }
    for name, value in record.items():
        spec = field_spec(name)
        if is_empty(value):
            questions[f"{name}::absence_wrong"] = Noul(
                instructions={
                    "field_spec": spec,
                    "extracted_field": value,
                    "main_question": ABSENCE_QUESTION,
                },
                criteria=ABSENCE_CRITERIA,
            )
            continue
        for metric, (question, criteria) in MAIN_QUESTIONS.items():
            if metric == "type_mismatch" and spec["type"] == "unknown":
                continue
            questions[f"{name}::{metric}"] = Noul(
                instructions={
                    "field_spec": spec,
                    "extracted_field": value,
                    "main_question": question,
                },
                criteria=criteria,
            )
    return questions


@json_cache
def verify(record: dict) -> dict[str, float | str]:
    """Run the whole Noul battery over a record in one TypeSafe call; return ``{field::metric: P(true)}``."""
    state = {
        "system_message": EXTRACT_SYSTEM,
        "instruction": "Extract the structured record from this document",
        "source_text": row["content"],
        "schema": schema,
        "extraction": record,
    }
    questions = build_questions(record)
    answers = ts.system_one(state=state, questions=questions, model=TS_MODEL).answers
    return {qid: ans.noul for qid, ans in answers.items()} | {
        "playground_link": make_playground_link(state, questions)
    }
Запуск полного набора проверок на извлечении модели mini
PYTHON THEME={NULL}
api.wedstack.ru/v1
checks = verify(mini_record)
playground_link = checks.pop("playground_link")
display(
    Markdown(
        f"🔗 [Open this verification in the TypeSafe playground]({playground_link})"
    )
)

print(f"{'qid':<40}{'P(wrong)':>9}")
print("-" * 50)
for fld, p in sorted(checks.items(), key=lambda c: -c[-1]):
    flag = "  <== FIRES" if p > FIRE_T else ""
    print(f"{fld:<40}{p:>9.2f}{flag}")
PLAINTEXT
api.wedstack.ru/v1
qid                                      P(wrong)
--------------------------------------------------
description::hallucinated                    0.95  <== FIRES
description::off_target                      0.85  <== FIRES
description::unreasonable                    0.58
__overall__::judge                           0.56
description::incomplete                      0.16
registration_open_date::absence_wrong        0.14
description::format_violation                0.10
description::name_desc_mismatch              0.08
description::type_mismatch                   0.02
Открыть эту верификацию в TypeSafe Playground →
- TypeSafe фокусирует сигнал именно на тех полях, где действительно есть ошибки.
- Результаты калиброваны: высокие значения для ошибочного поля, низкие для правильного поля, средние для поля, которое выглядит сомнительно, но не является явно ошибочным.
- В этом и заключается преимущество типизированного верификатора над прямолинейной общей оценкой «хороша ли запись целиком?».
Шаг 4: Гейт эскалации
- теперь настраиваем гейт по условию
any_flag: эскалировать, если хотя бы один флаг поля превышаетFIRE_T(0.7, заданный выше и отмеченный маркером<== FIRESна Шаге 3); - это логика типа
max(эскалация при срабатывании любого флага), а не среднее значение, поэтому одного уверенного тревожного сигнала достаточно, чтобы запустить эскалацию, вместо его размытия усреднением.
PYTHON THEME={NULL}
api.wedstack.ru/v1
# any_flag is a per-field gate: the holistic __overall__ head is shown above but not part of it
fired = {
    qid: p
    for qid, p in checks.items()
    if not qid.startswith("__overall__") and p > FIRE_T
}
escalate = bool(fired)

print(
    f"any_flag gate (threshold {FIRE_T}): {'ESCALATE' if escalate else 'ACCEPT cheap result'}"
)
for qid, p in sorted(fired.items(), key=lambda c: -c[1]):
    print(f"  fired: {qid}  (P={p:.2f})")
PLAINTEXT
api.wedstack.ru/v1
any_flag gate (threshold 0.7): ESCALATE
  fired: description::hallucinated  (P=0.95)
  fired: description::off_target  (P=0.85)
Шаг 5: Эскалация на модель рассуждений (reasoning model)
Поскольку сигнал сработал, мы подключаем сильную модель (gpt-5.5, reasoning_effort="high"):
PYTHON THEME={NULL}
api.wedstack.ru/v1
final_record = (
    extract(REASONING, prompt, schema, content, reasoning_effort="high")
    if escalate
    else mini_record
)

print("mini      :", json.dumps(mini_record))
print("reasoning :", json.dumps(final_record))
print("\nfield-level diff (mini -> final):")
for name in mini_record:
    if mini_record[name] != final_record.get(name):
        print(f"  {name}: {mini_record[name]!r}  ->  {final_record.get(name)!r}")
PLAINTEXT
api.wedstack.ru/v1
mini      : {"registration_open_date": "", "description": "Registration opens for the fall semester"}
reasoning : {"description": "", "registration_open_date": ""}

field-level diff (mini -> final):
description: 'Registration opens for the fall semester' -> ''- Результат оптимизации
- Рассуждающая модель отбрасывает выдуманное поле
description, возвращая пустую строку"". - Она распознала, что на странице отсутствует информация о дате регистрации, и отказалась ее придумывать.
- Каскад превратил уверенную, валидную по схеме галлюцинацию в честное пустое поле.
- При этом затраты на мощную модель были совершены только потому, что верификатор прямо указал на ошибку.
- Рассуждающая модель отбрасывает выдуманное поле
Шаг 6: Как это выглядит на 100 промптах
- Это внутренние результаты TypeSafe, полученные по описанной выше методике:
- тот же цикл
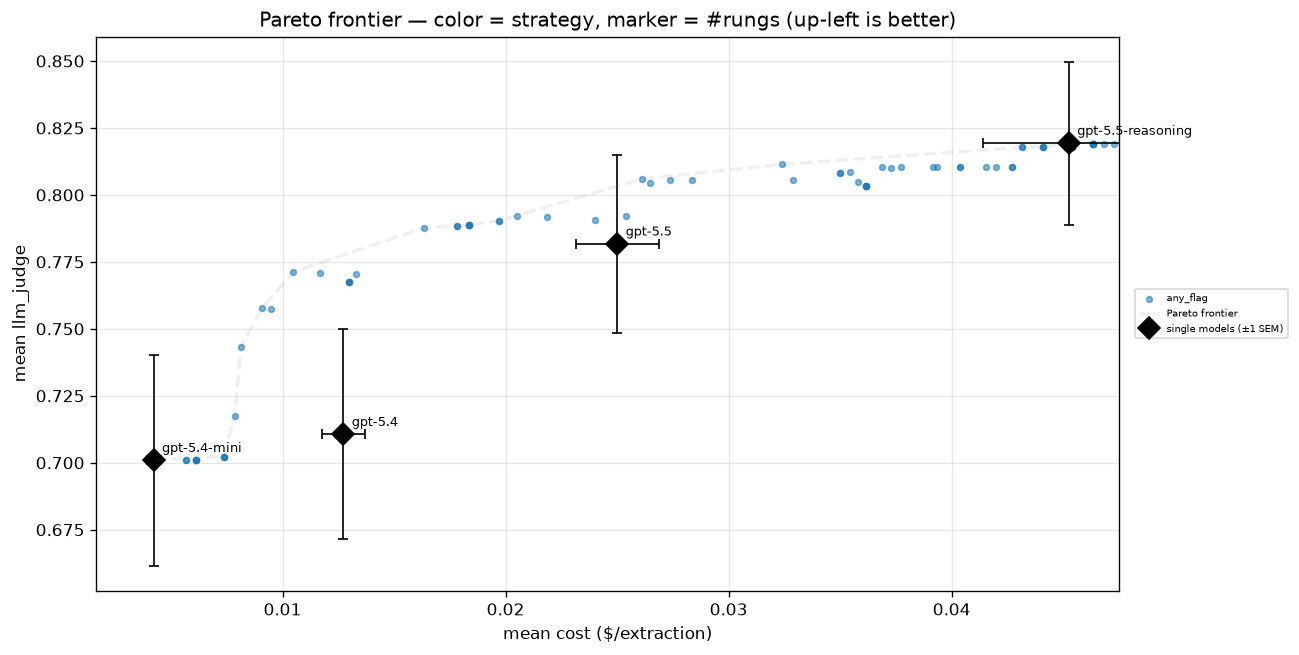
извлечение → верификация → эскалация, связкаgpt-5.4-mini → gpt-5.5-reasoning, гейтany_flagпо полям, протестированные на 100 промптах scrapegraphai; - для каждого примера дешевое извлечение оценивается в TypeSafe; порог срабатывания гейта варьируется от 0 до 1, и каждая конфигурация наносится на график в координатах (стоимость, качество);
- график представляет собой исторический снимок; затраты не пересчитывались по текущим тарифам модели Jev.
- тот же цикл
- Как читать этот график:
- черные ромбы — четыре модели, запущенные самостоятельно (стоимость растет по мере возможностей; самая мощная,
gpt-5.5-reasoning, находится в верхнем правом углу с качеством ≈0.81 при стоимости ≈$0.10 за извлечение); - синие точки — каскад при различных порогах срабатывания гейта; пунктирная линия обозначает границу Парето (pareto frontier);
- граница каскада проходит выше и левее каждой отдельной модели: варьирование порога позволяет получить большую часть качества лучшей модели за малую долю ее стоимости;
- дешевый уровень берет на себя простые примеры практически бесплатно, и лишь отмеченные сомнительные записи оплачивают работу модели рассуждений.
- черные ромбы — четыре модели, запущенные самостоятельно (стоимость растет по мере возможностей; самая мощная,
Приложение A: Что делает сигнал верификатора качественным
- эффективность каскада напрямую определяется качеством его верификатора; вот что отличает полезный сигнал от бесполезного:
- Узкий и привязанный к источнику (grounded).
- четкий проверяемый вопрос да/нет по одному полю относительно источника (например, «отсутствует ли это значение в источнике?»), а не размытый вопрос «хорошо ли выполнено извлечение?»;
- неконкретные вопросы дают размытые, некалиброванные оценки.
- Ошибка = TRUE, с явными критериями.
- формулируйте каждый вопрос так, чтобы случай необходимости эскалации соответствовал ответу
true, и явно описывайте значенияtrue/false.
- формулируйте каждый вопрос так, чтобы случай необходимости эскалации соответствовал ответу
- По полям с последующей агрегацией через
max.- проверка по отдельным полям локализует ошибку и сохраняет четкость сигнала;
- функция
max(«сработал хотя бы один флаг») гарантирует эскалацию при уверенном обнаружении одной ошибки вместо ее сглаживания усреднением.
- Независимый и недорогой.
- специализированный верификатор (в данном случае TypeSafe), оценивающий результат со стороны, компенсирует слепые зоны экстрактора;
- верификатор обязан быть дешевым, иначе вся финансовая выгода каскада сойдет на нет.
- Разделяющий и калиброванный.
- качественный сигнал дает высокие значения на реальных ошибках и низкие на корректных данных, благодаря чему один фиксированный порог четко разделяет приемлемый результат и эскалацию;
- именно эта разделительная способность сдвигает кривую Парето вверх и влево.
- Узкий и привязанный к источнику (grounded).